模型控制台
模型是可选择、可下载、可排障的生产能力层
Speech、Transcribe、声音转换、Voice Design 和 Alignment 都由同一份模型注册表管理。页面重点不是列名字,而是帮用户理解每个模型能做什么、何时下载、如何进入工作流。
模型库
按产品能力组织模型,而不是把模型全集平铺给用户
每个模型条目都会带有任务类型、默认 variant、推荐内存、语言范围、运行时依赖和下载状态。下载进入 任务与进度,模型缓存留在 Sonano 管理目录。
- 模型状态:available、dependency missing、not downloaded、not installed
- variant 状态独立展示,参数规模不冒充下载体积
- OmniVoice / VoxCPM2 共享 MLX 运行时,只需下载模型权重
- GUI、API 和 Agent 读取同一份模型注册表
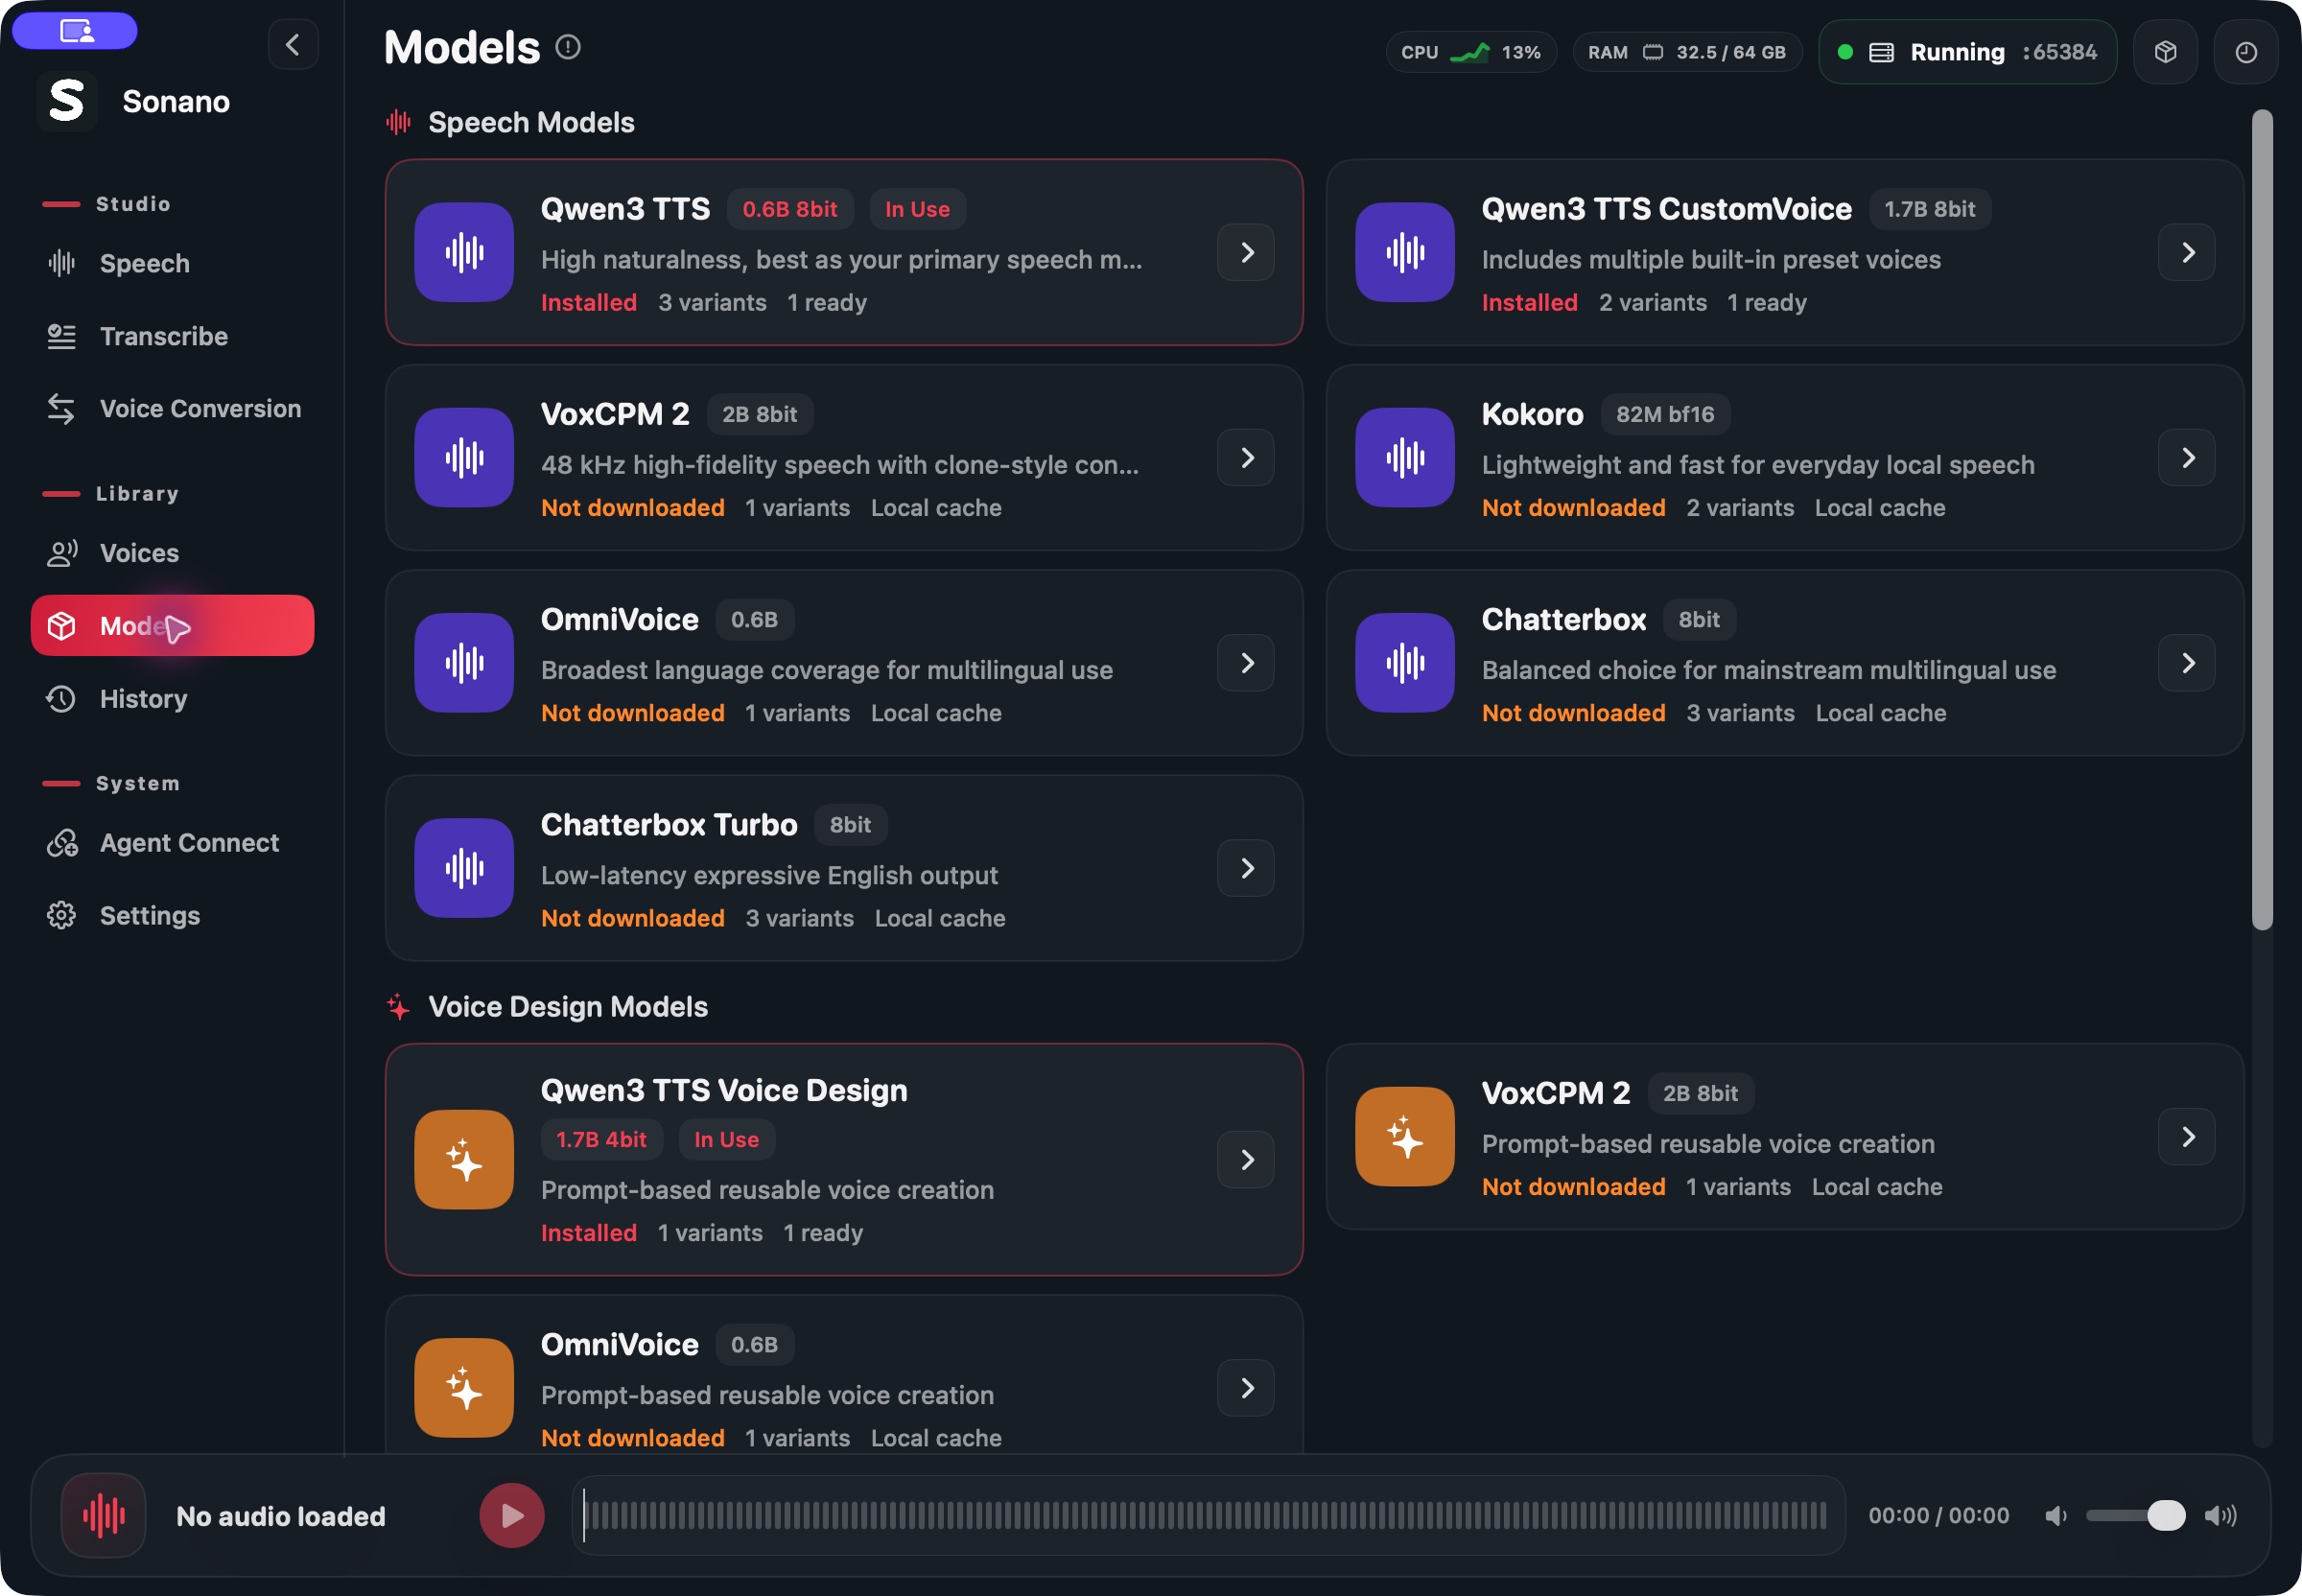
模型操作层
从全局模型库到模型详情,状态要能被看懂
官网需要展示的不是“支持很多模型”这句话,而是用户在 App 里如何理解下载、切换、依赖、变体和就绪状态。模型库弹框适合说明全局入口,详情层适合说明每个模型的上下文信息。
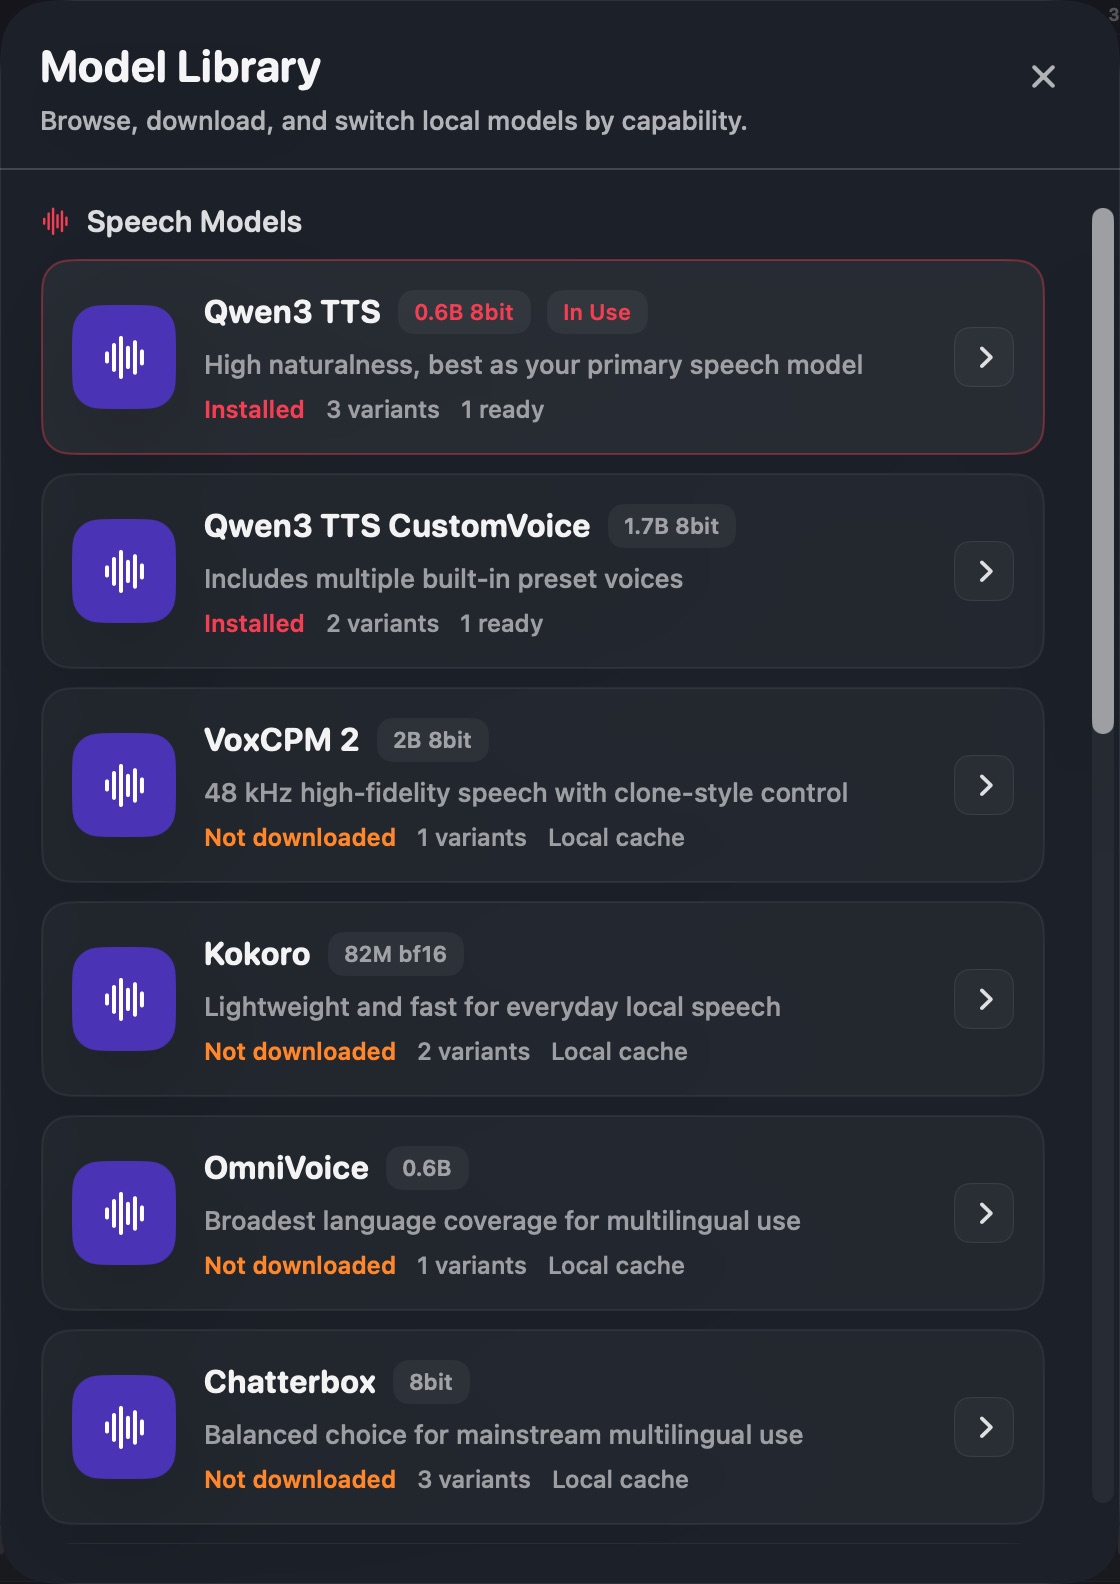
Global Library
右上角模型库入口
用户可以不离开当前工作流,查看可用模型、安装状态和当前任务能力。
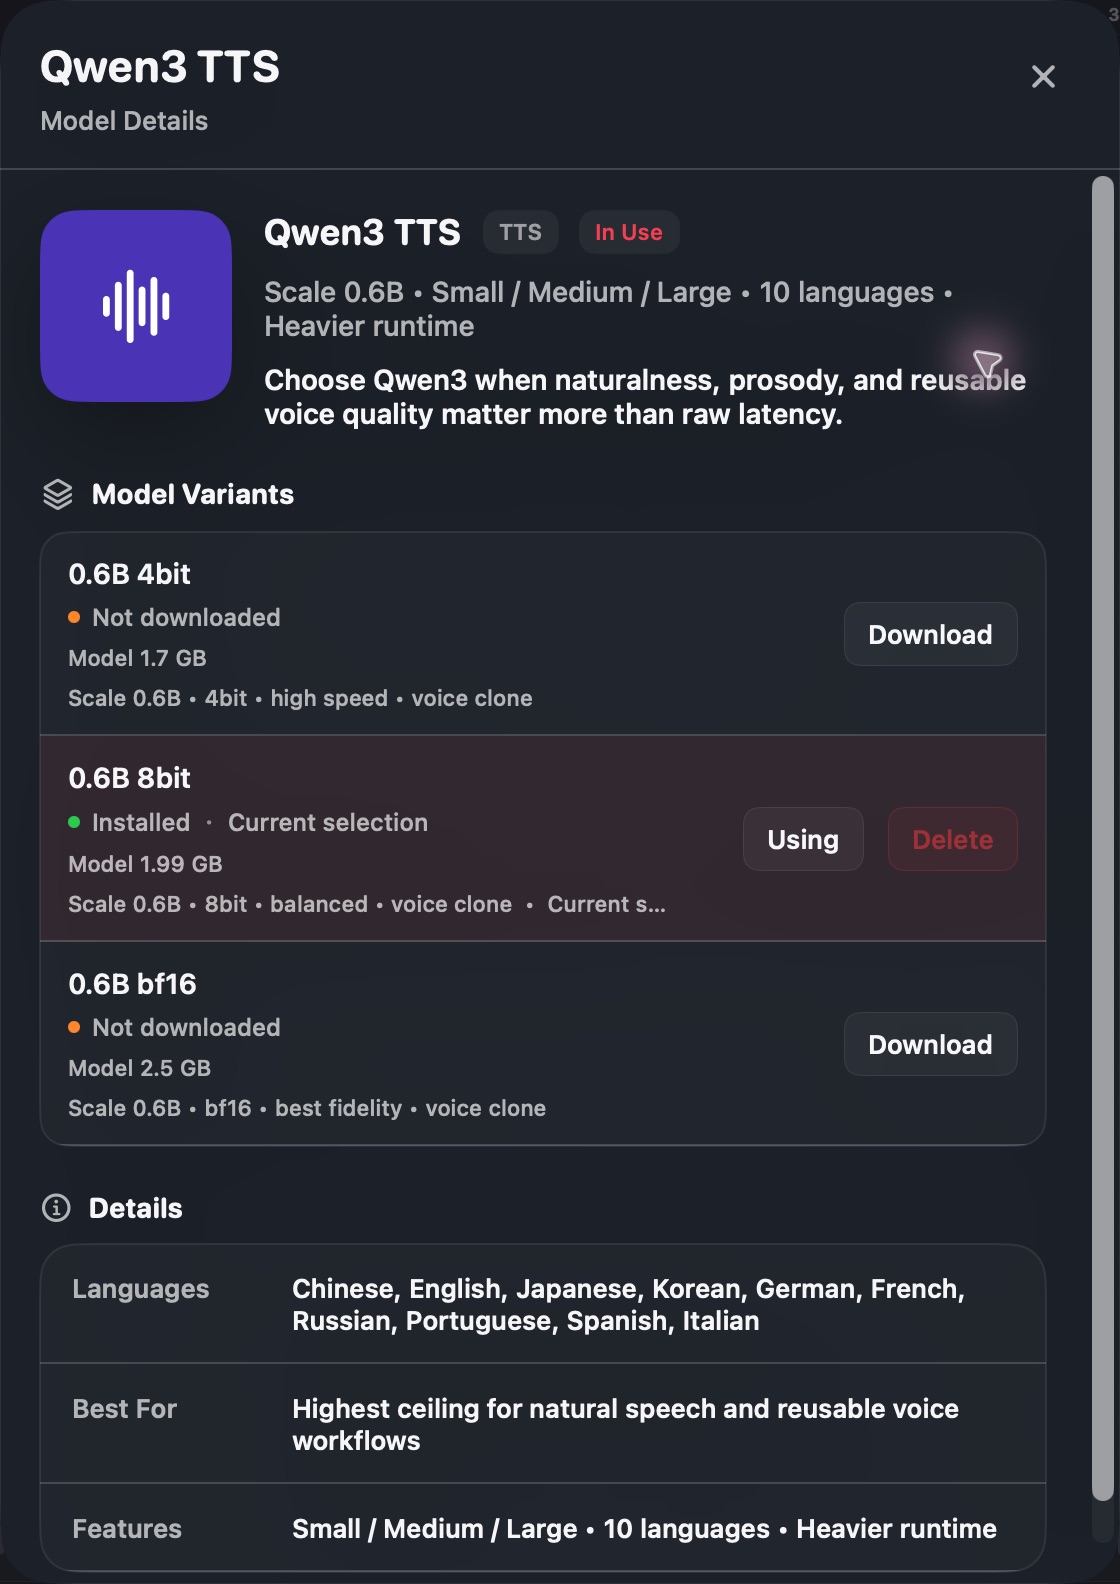
Model Detail
模型详情解释能力边界
详情层承接模型用途、支持语言、运行依赖和状态说明,帮助用户判断是否应该下载或切换。
语音模型
语音生成模型矩阵
| 模型 | 定位 | 语言 | 声音入口 | Variant / 运行时 |
|---|---|---|---|---|
| Kokoro | 轻量 TTS,适合快速朗读和内置 preset 声音。 | 英语、日语、中文、法语、西语、意大利语、葡语、印地语。 | Kokoro preset voices,完整 voice pack 由受管下载拉取。 | 82M bf16 / 8bit;默认 bundled MLX audio runtime。 |
| Qwen3 TTS | 多语言主路径 Speech,引入 Voice Asset 进行克隆型发声。 | 中文、英文、日文、韩文、德文、法文、俄文、葡文、西文、意大利文。 | 使用 factory / designed / cloned 的 voice_asset_id。 |
0.6B Base 4bit / 8bit / bf16;支持流式预听。 |
| Qwen3 TTS CustomVoice | 使用模型内置 speaker 的 preset 语音路线。 | auto + Qwen3 多语言集合。 | Vivian、Serena、Uncle Fu、Dylan、Eric、Ryan、Aiden、Ono Anna、Sohee 等 runtime voice。 | 0.6B / 1.7B CustomVoice 8bit;支持 style instructions 与流式预听。 |
| Qwen3 VoiceDesign | 显式 Voice Design 路线,用自然语言描述生成可保存的设计音色。 | 中文、英文、日文、韩文、德文、法文、俄文、葡文、西文、意大利文。 | 生成 sample audio + matching text,保存后进入统一 Voice Asset 列表。 |
1.7B VoiceDesign 4bit;当前产品层默认主设计档位。 |
| Chatterbox Turbo | 偏低延迟、表达力更强的英文 Speech / Voice Clone 候选。 | 英语优先。 | 使用 Sonano Voice Asset;适合英文表达型场景。 | Small 4bit / Medium 8bit / Large fp16;依赖 S3TokenizerV2。 |
| Chatterbox | 多语言 expressive TTS 候选,覆盖更多非英语场景。 | 阿拉伯语、中文、日文、韩文、德文、法文、西文、葡文、俄文等 20+ 语言。 | 使用 Sonano Voice Asset;和 Chatterbox Turbo 共用部分运行依赖。 | Small 4bit / Medium 8bit / Large fp16;依赖 S3TokenizerV2。 |
| OmniVoice | 长尾语言覆盖和 Voice Clone / Voice Design 的多语言兜底。 | auto / 600+,长尾语言通过语言搜索接口按需查询。 | 使用 factory / designed / cloned 的 voice_asset_id。 |
0.6B omnilingual;runtime 按需安装到 Application Support。 |
| VoxCPM 2 | 48 kHz 多语言 Speech、Voice Clone 和 Voice Design 路线。 | 中文、英文、日文、韩文、法文、德文、俄文、泰文、越南文等 30 语种。 | 支持 voice_asset_id + instructions 的风格控制。 |
mlx-community/VoxCPM2-8bit;共享 MLX 运行时。 |
其他模型家族
转写、对齐和声音转换模型
| 模型 | 任务 | 用途 | Variant / 说明 |
|---|---|---|---|
| Qwen3-ASR | STT / 字幕 | 本地转写、字幕、时间线;支持中文、英文、日文、韩文、法文、德文、西文等。 | 0.6B 8bit / bf16、1.7B 8bit;默认依赖 Qwen3 ForcedAligner。 |
| Whisper | STT / 兜底转写 | 广泛语言覆盖的本地转写备选,适合 Qwen3-ASR 语言范围外的素材。 | Tiny / Base / Small / Medium / Large Turbo / Large V3。 |
| Qwen3 ForcedAligner | 对齐 / 字级时间戳 | 服务 Qwen3-ASR 的 unit timestamp 与字幕对齐排障。 | 0.6B 4bit;中、英、日、韩。 |
| Chatterbox VC | 声音转换 | 输入源音频和目标 Voice Asset,输出波形级 timbre conversion 结果。 | VC fp16;目标声音必须是 factory / designed / cloned。 |
评估维度
本地 TTS 不是只看“听起来最好”,还要看能否稳定进入工作流
语言覆盖
先确认目标语言、口音和脚本是否被模型支持。OmniVoice 更适合长尾语言,Qwen3 / VoxCPM2 更适合明确语言集合内的稳定生产。
声音入口
preset voice、factory voice、designed voice、cloned voice 是不同资产类型。能不能使用 voice_asset_id,比模型名字更重要。
延迟与预听
短文本、交互式编辑和 Agent 自动化需要低等待。Qwen3 流式预听和 Chatterbox Turbo 的低延迟定位服务这类场景。
本机部署成本
模型权重、Python runtime、内存建议、Apple Silicon / MLX 支持都会影响实际可用性。Sonano 把权重下载和 runtime 安装分开展示。
可审查产物
一个好模型还要能产出可播放、可导出、可回到历史和 Agent artifact 的结果,而不是只在 demo 里返回一段临时音频。
维护边界
开源模型更新很快。Sonano 只把已有 adapter、运行时和下载路径可管理的模型放进注册表,避免把用户带进半成品路线。
选择建议
怎么选模型
快速中文/英文朗读
优先用 Qwen3 TTS CustomVoice 的内置 speaker;需要库内声音时切到 Qwen3 TTS + voice_asset_id。
自定义声音
factory、designed、cloned voices 是受管资产,可被 Qwen3 TTS、OmniVoice、Chatterbox 和 VoxCPM2 复用。
长尾语言
OmniVoice 面向 600+ 语言覆盖;Agent 不应拉全量语言表,而应按需搜索。
转写与字幕
Qwen3-ASR 是主路径,Whisper 是广覆盖备选;需要 unit timestamp 时依赖 ForcedAligner。
声音转换
Chatterbox VC 只接受受管 Voice Asset 作为目标,不接受普通 preset voice。
文本智能
通过外接 LLM Provider 提供脚本分析、转写清理和提示词辅助;核心音频素材与音频推理仍默认留在本机。
场景对照
把“最佳模型”翻译成具体工作流
| 场景 | 优先路线 | 为什么 | 注意事项 |
|---|---|---|---|
| 短文本快速朗读 | Qwen3 TTS CustomVoice 或 Kokoro | 内置 speaker / preset voice 上手快,不需要先准备 Voice Asset。 | 如果要复用自己的声音,应切到 Qwen3 TTS + voice_asset_id。 |
| 多语言配音 | Qwen3 TTS、VoxCPM2、Chatterbox Multilingual | 语言集合明确,适合在同一项目中管理多语种输出。 | 不同模型的语言参数会由 Sonano 规范化,不要把底层 token 当作 UI 文案。 |
| 长尾语言 / 少数语种 | OmniVoice | 覆盖范围大,适合作为 Voice Clone 和 Voice Design 的多语言兜底。 | Agent 应按需搜索语言,不要把 600+ 语言完整列表塞进上下文。 |
| 英文表达型内容 | Chatterbox Turbo | 偏低延迟和 expressive TTS,适合英文试听、对话和短内容迭代。 | 当前产品层仍以受管 Voice Asset 和统一 artifact 为边界。 |
| 高采样率多语言声音 | VoxCPM 2 | 48 kHz 是它在 Sonano 中的核心定位之一,适合更重的声音设计与克隆路线。 | 需要受管 runtime;安装和模型下载是两件事。 |
| 已有音频换声音 | Chatterbox VC | 输入源音频,选择受管目标声音,生成波形级 timbre conversion。 | 不能使用 preset voice,目标必须有 reference audio。 |
Sonano 的定位不是复刻某个模型排行榜,而是把多个本地模型封装成可下载、可审计、可复用、可由 Agent 调用的生产系统。