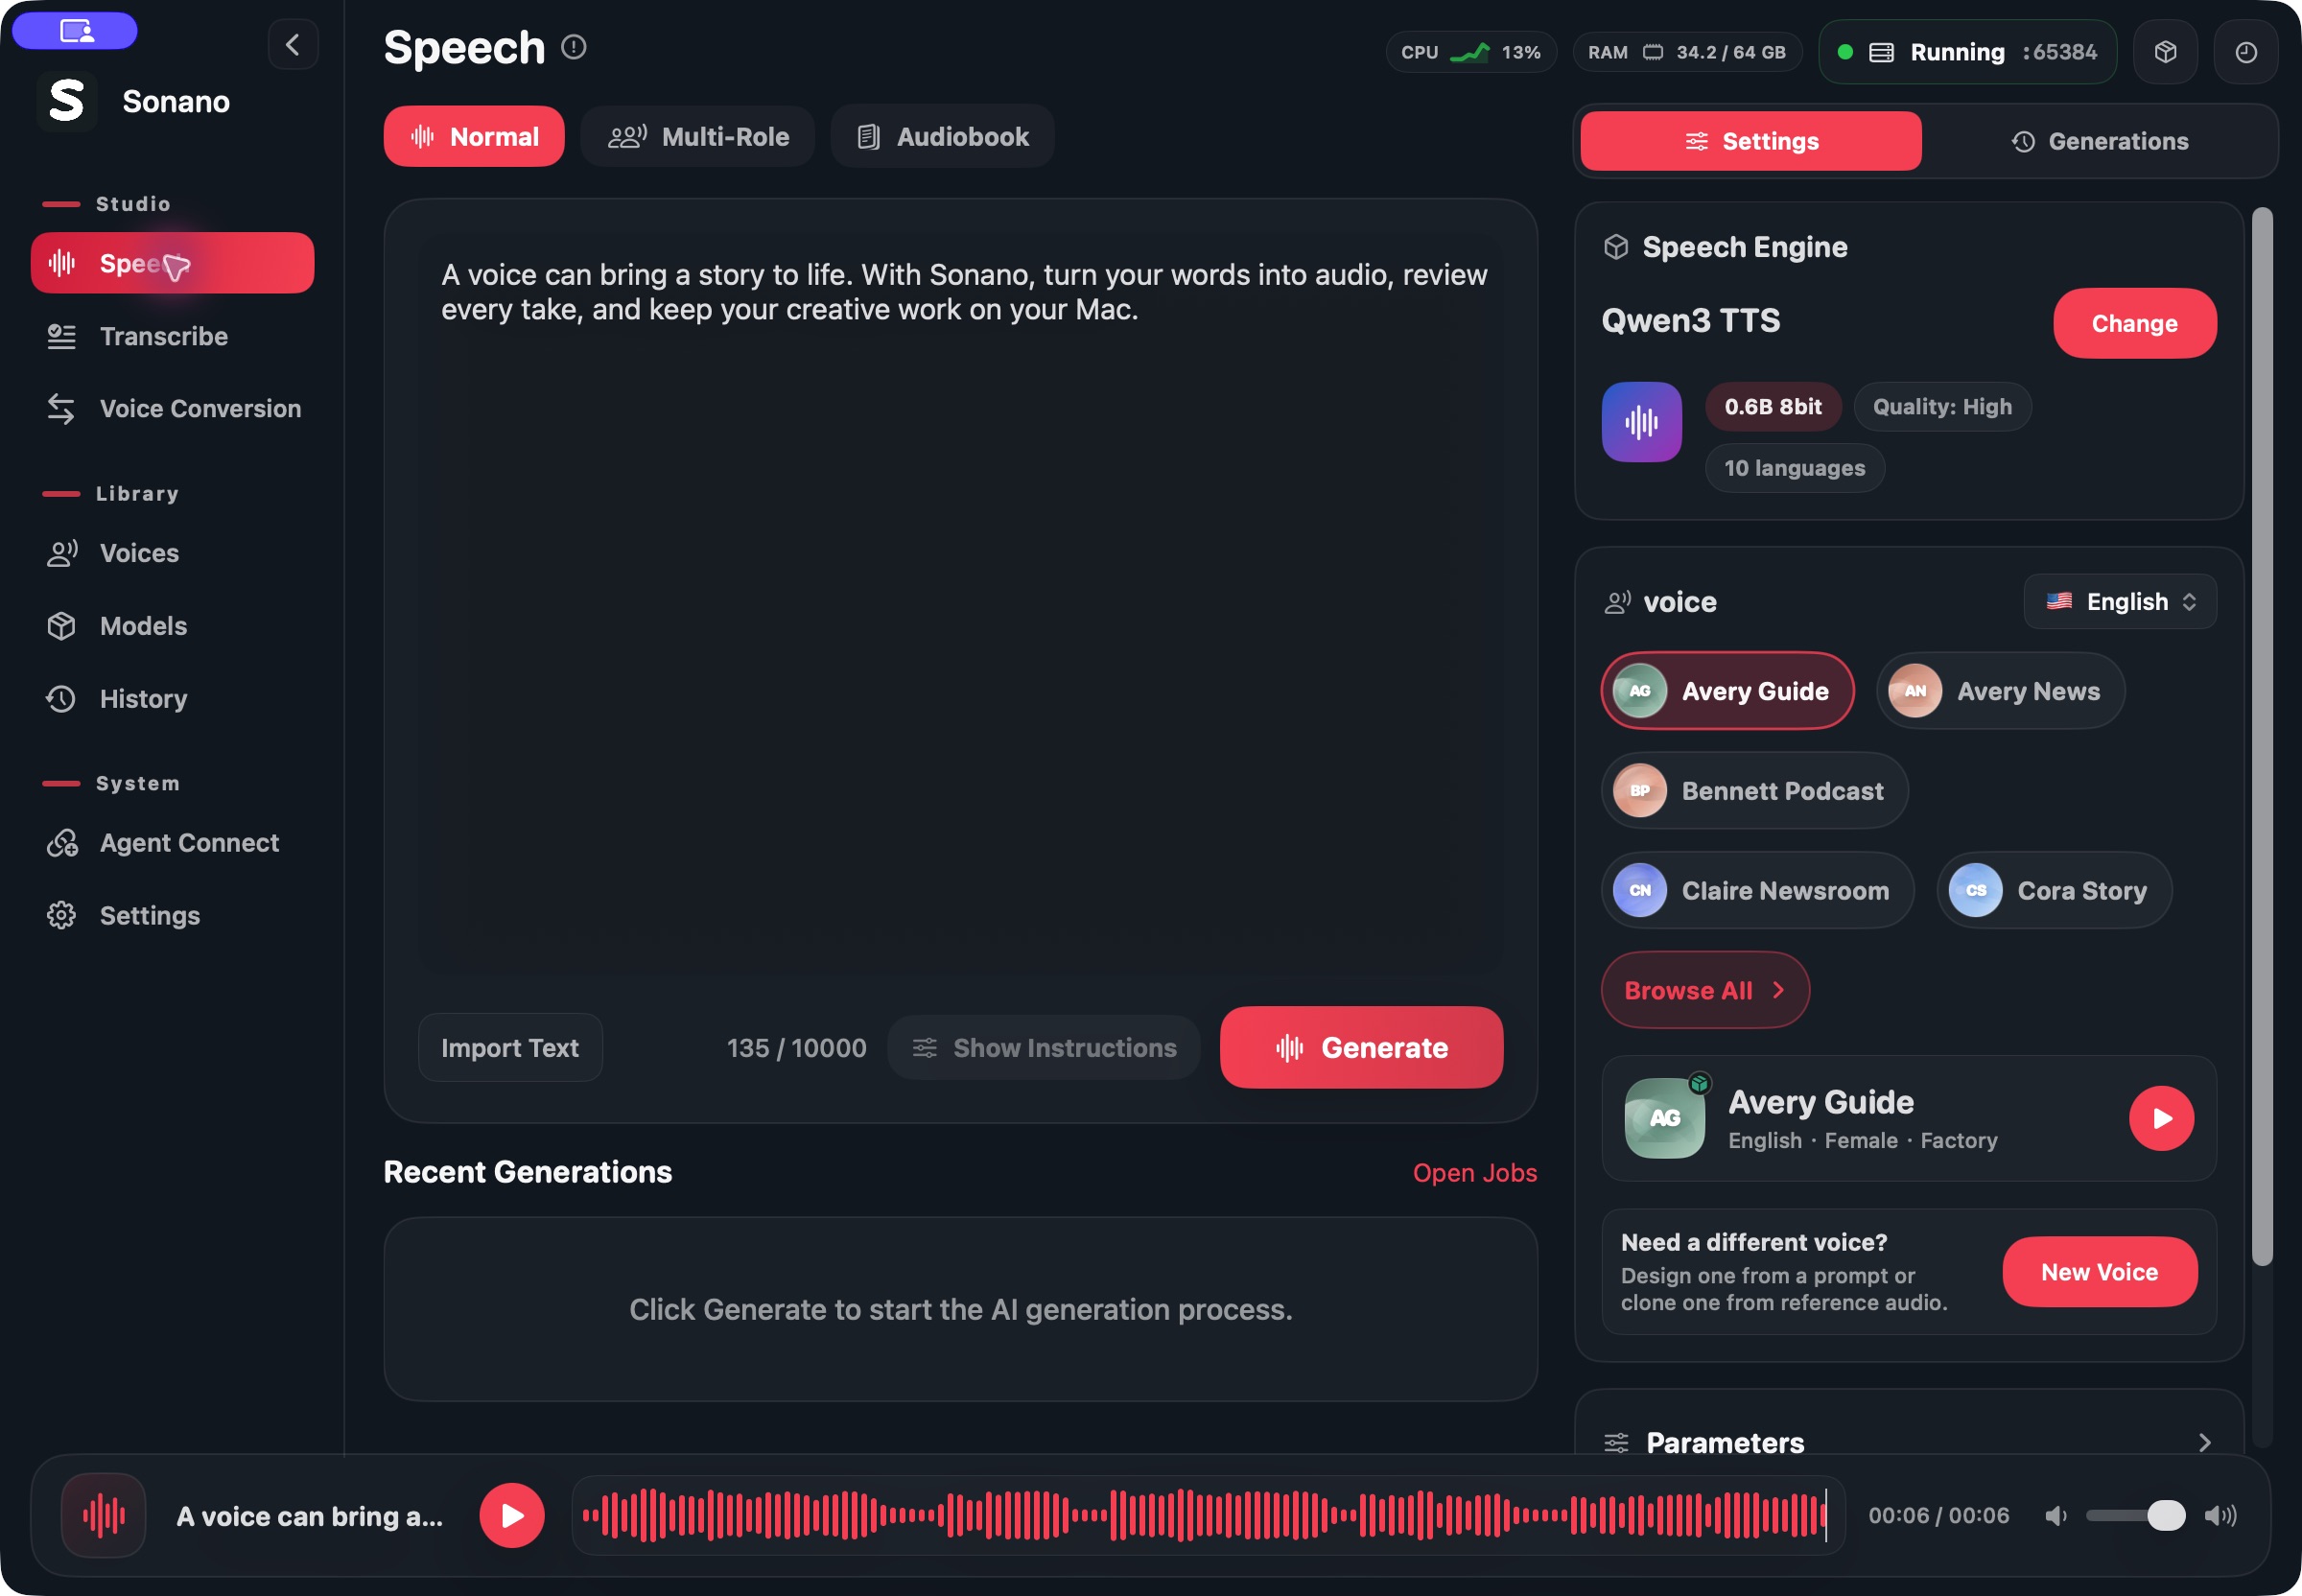
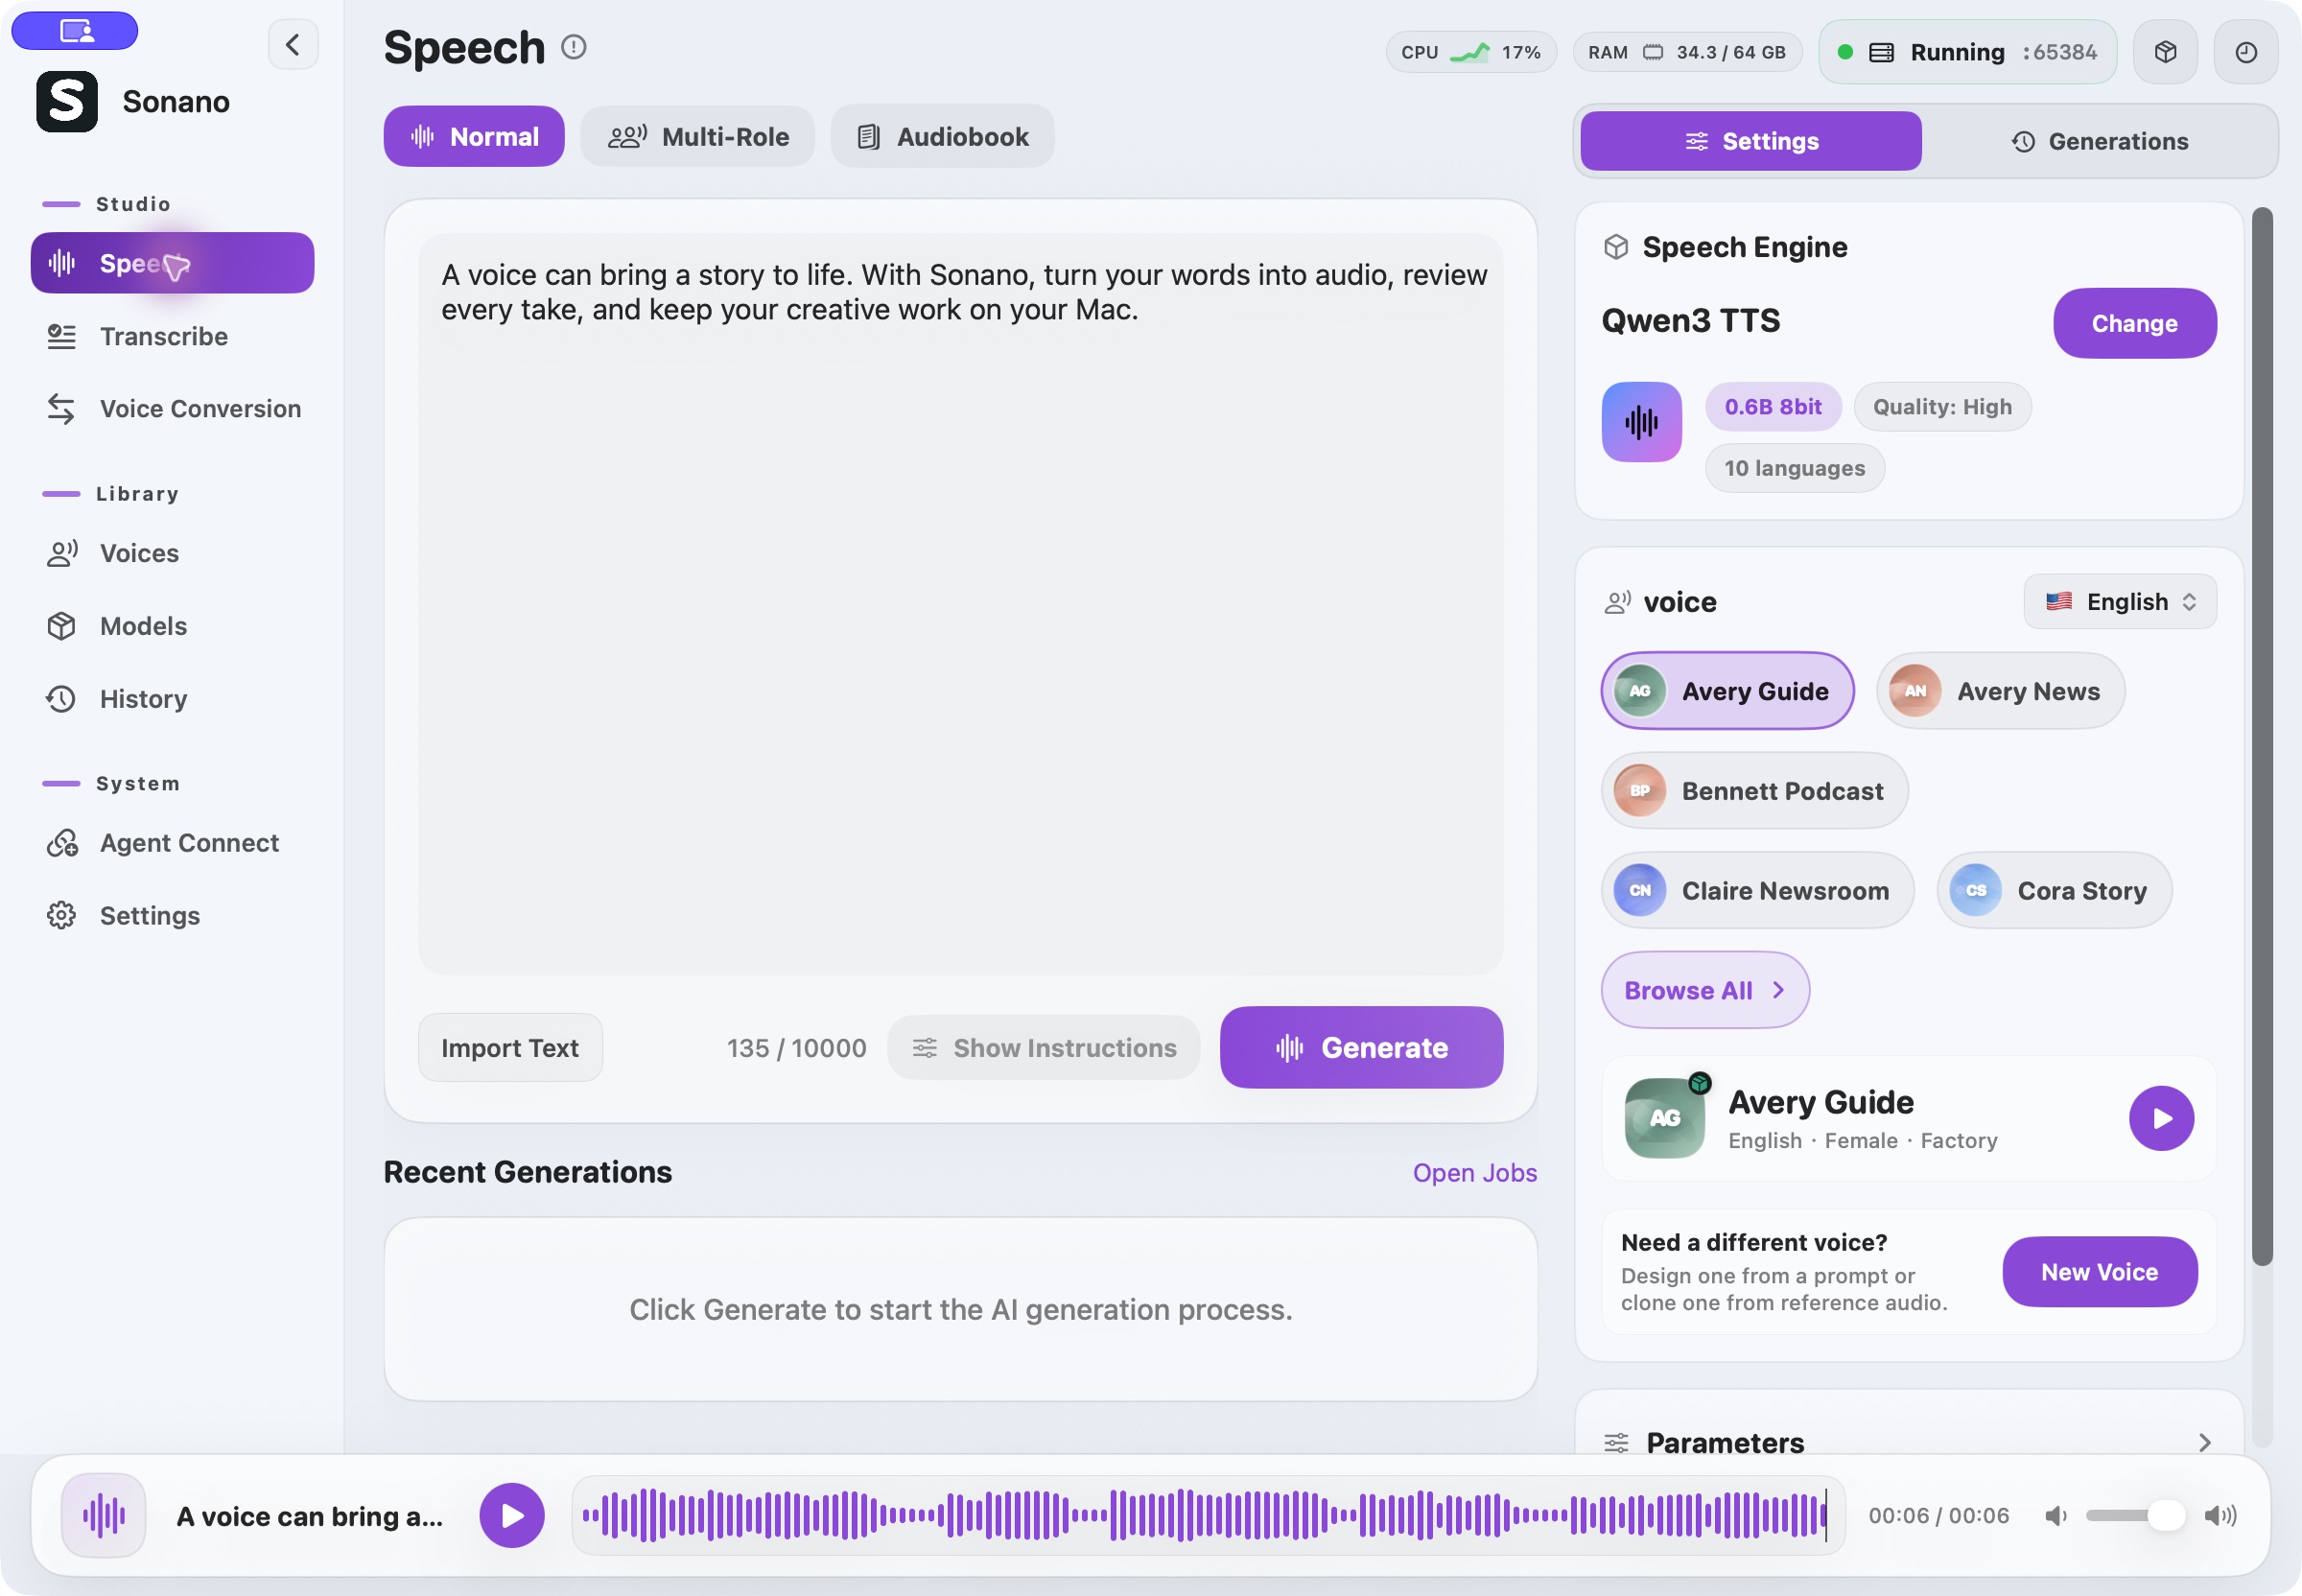
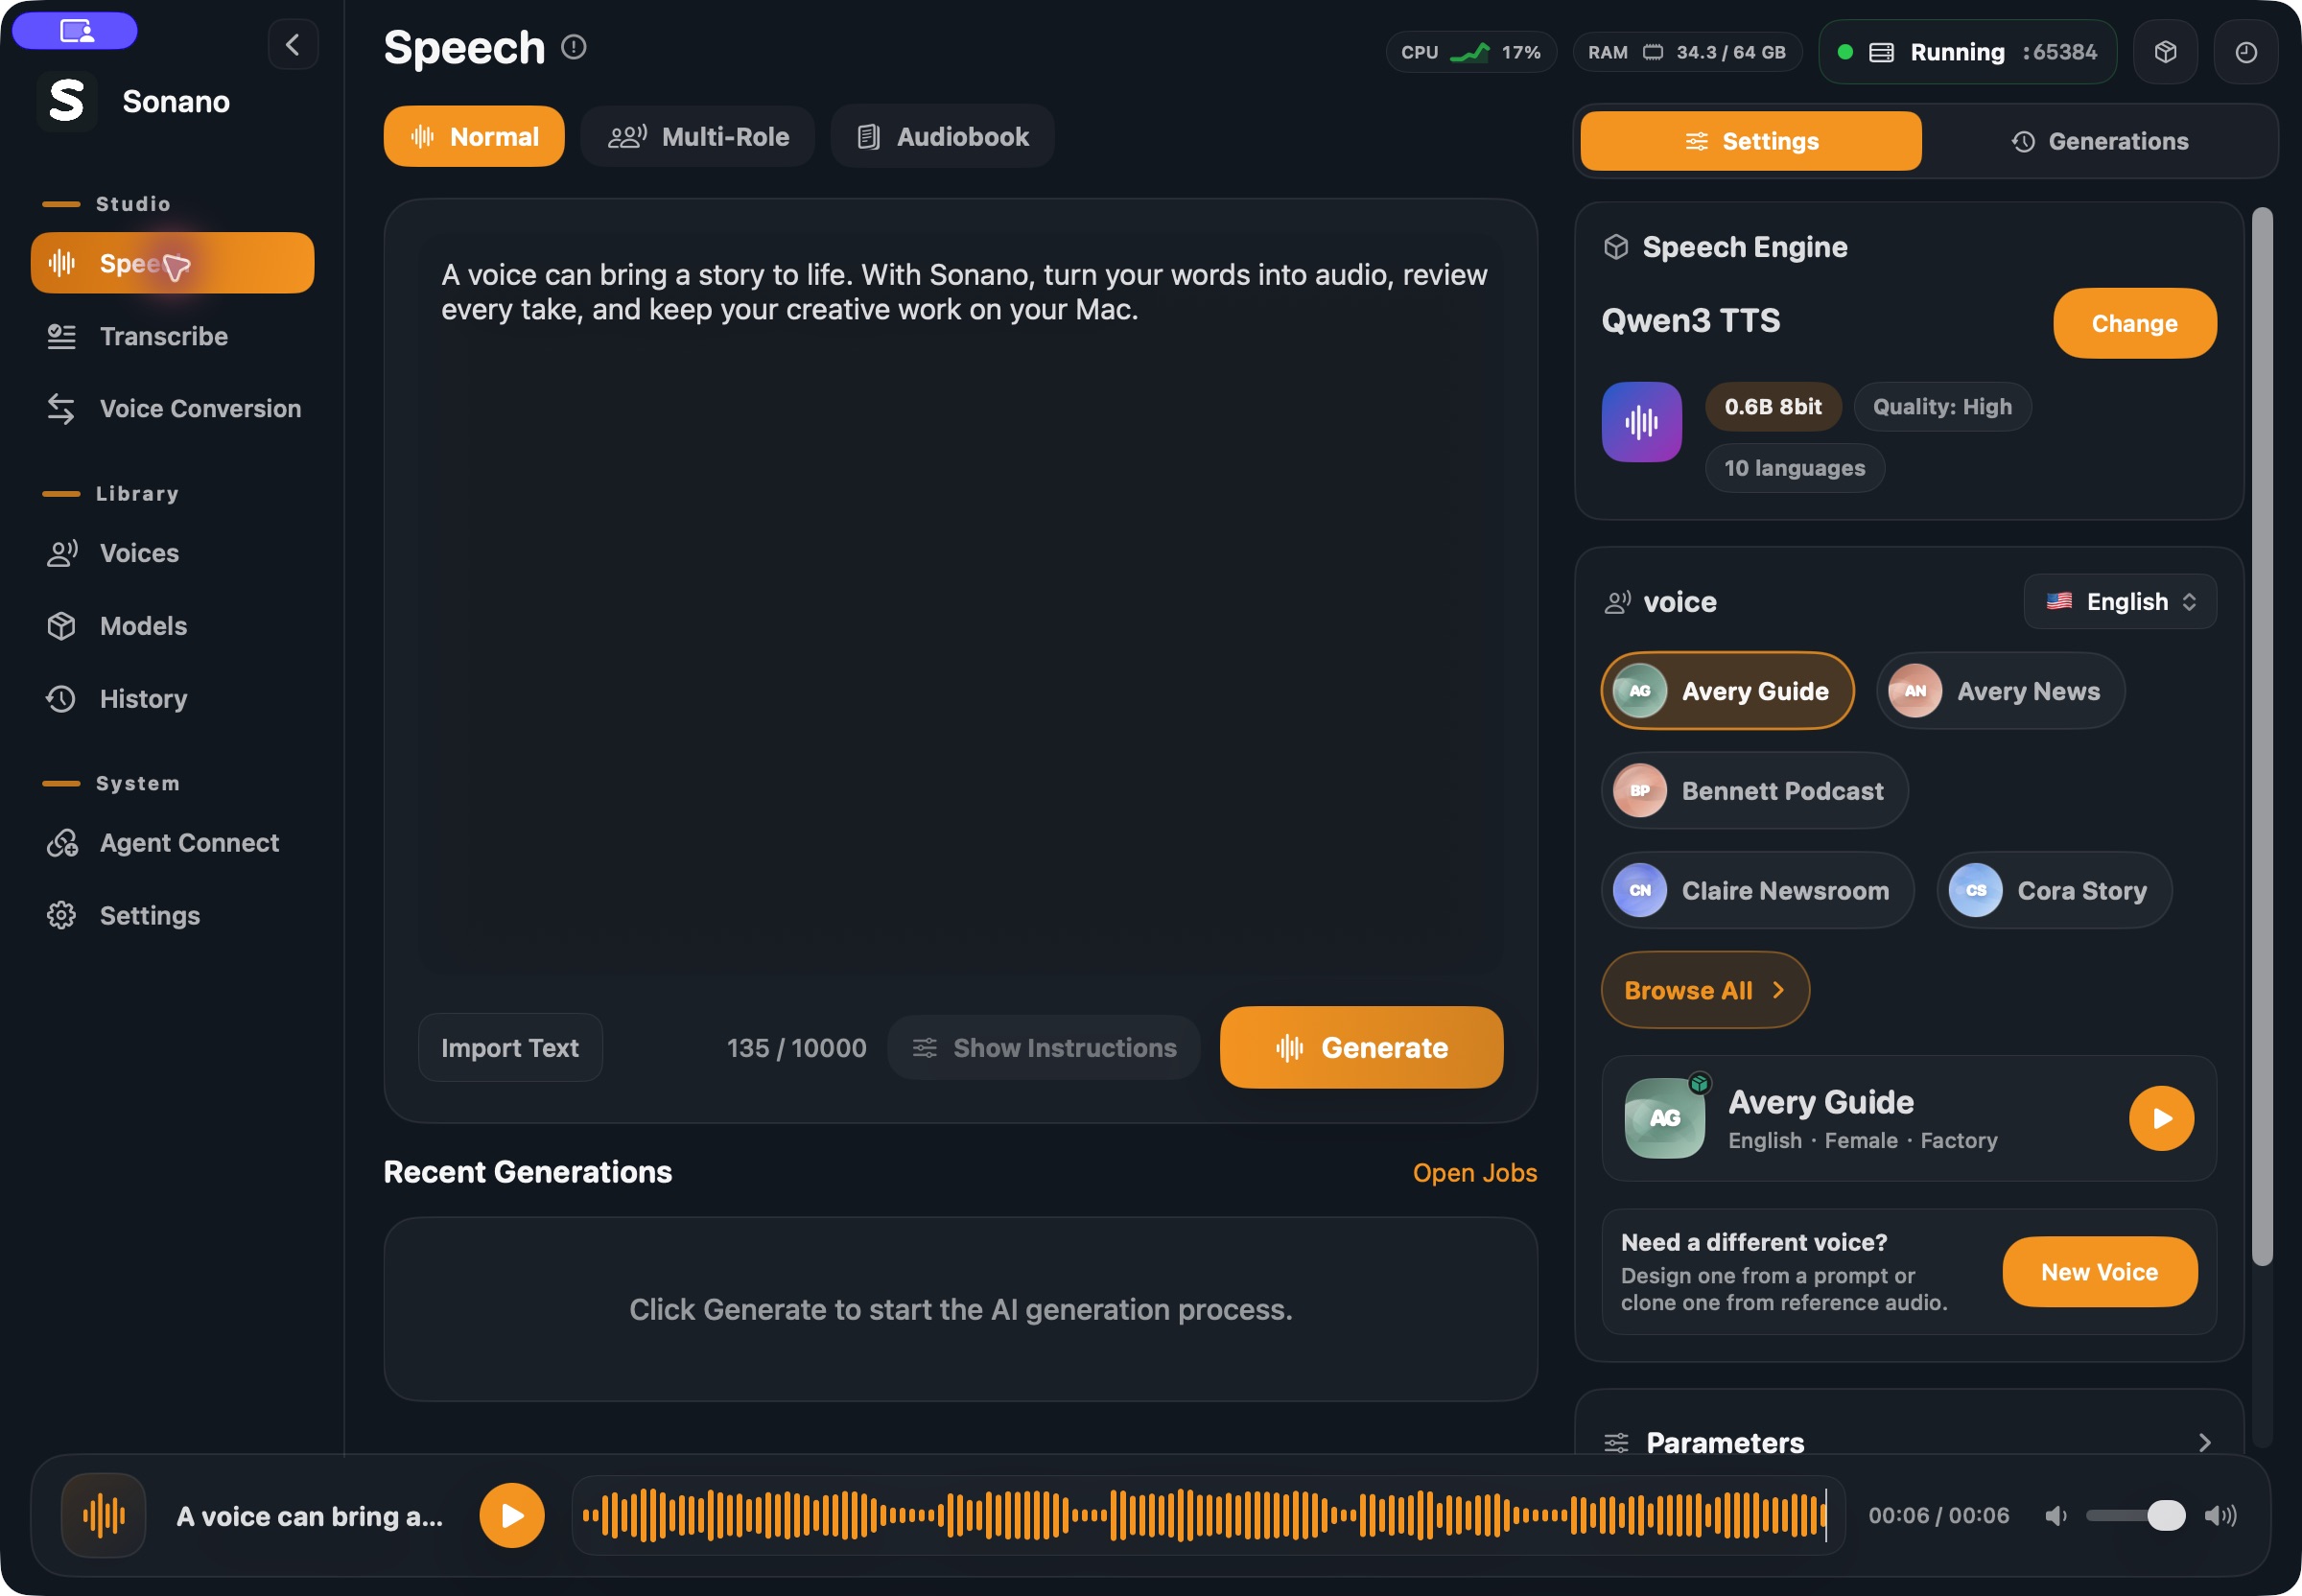
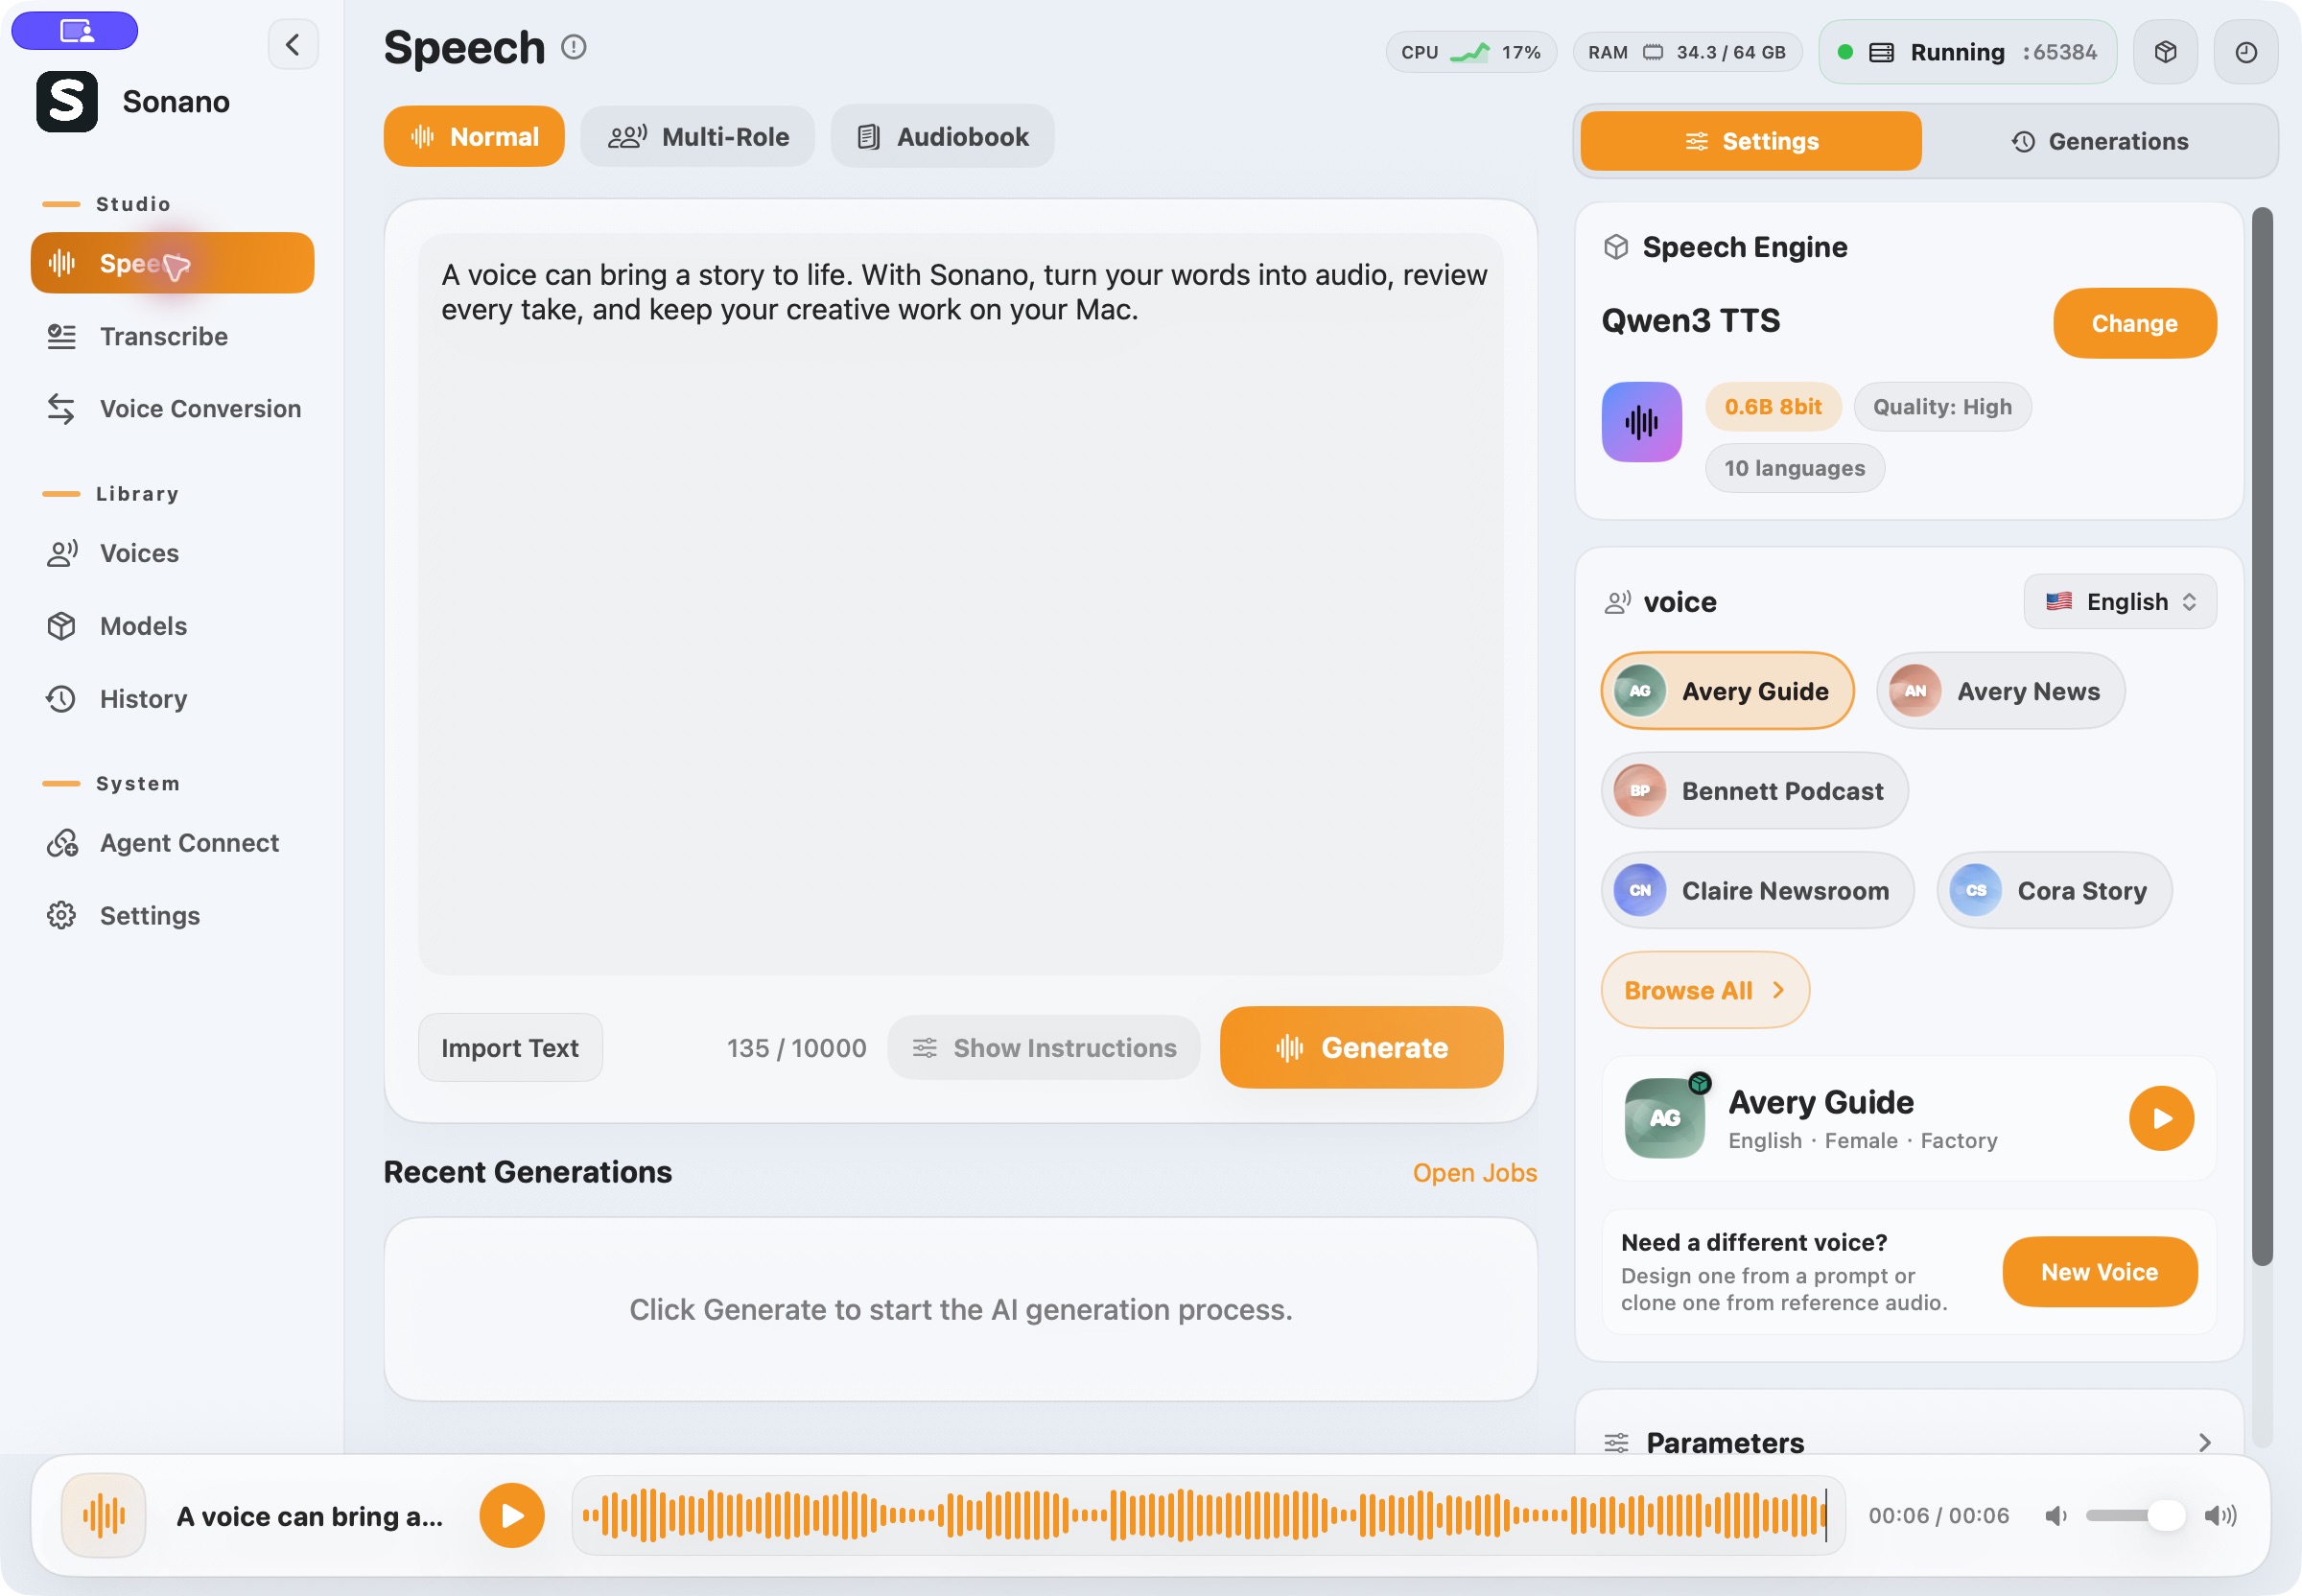
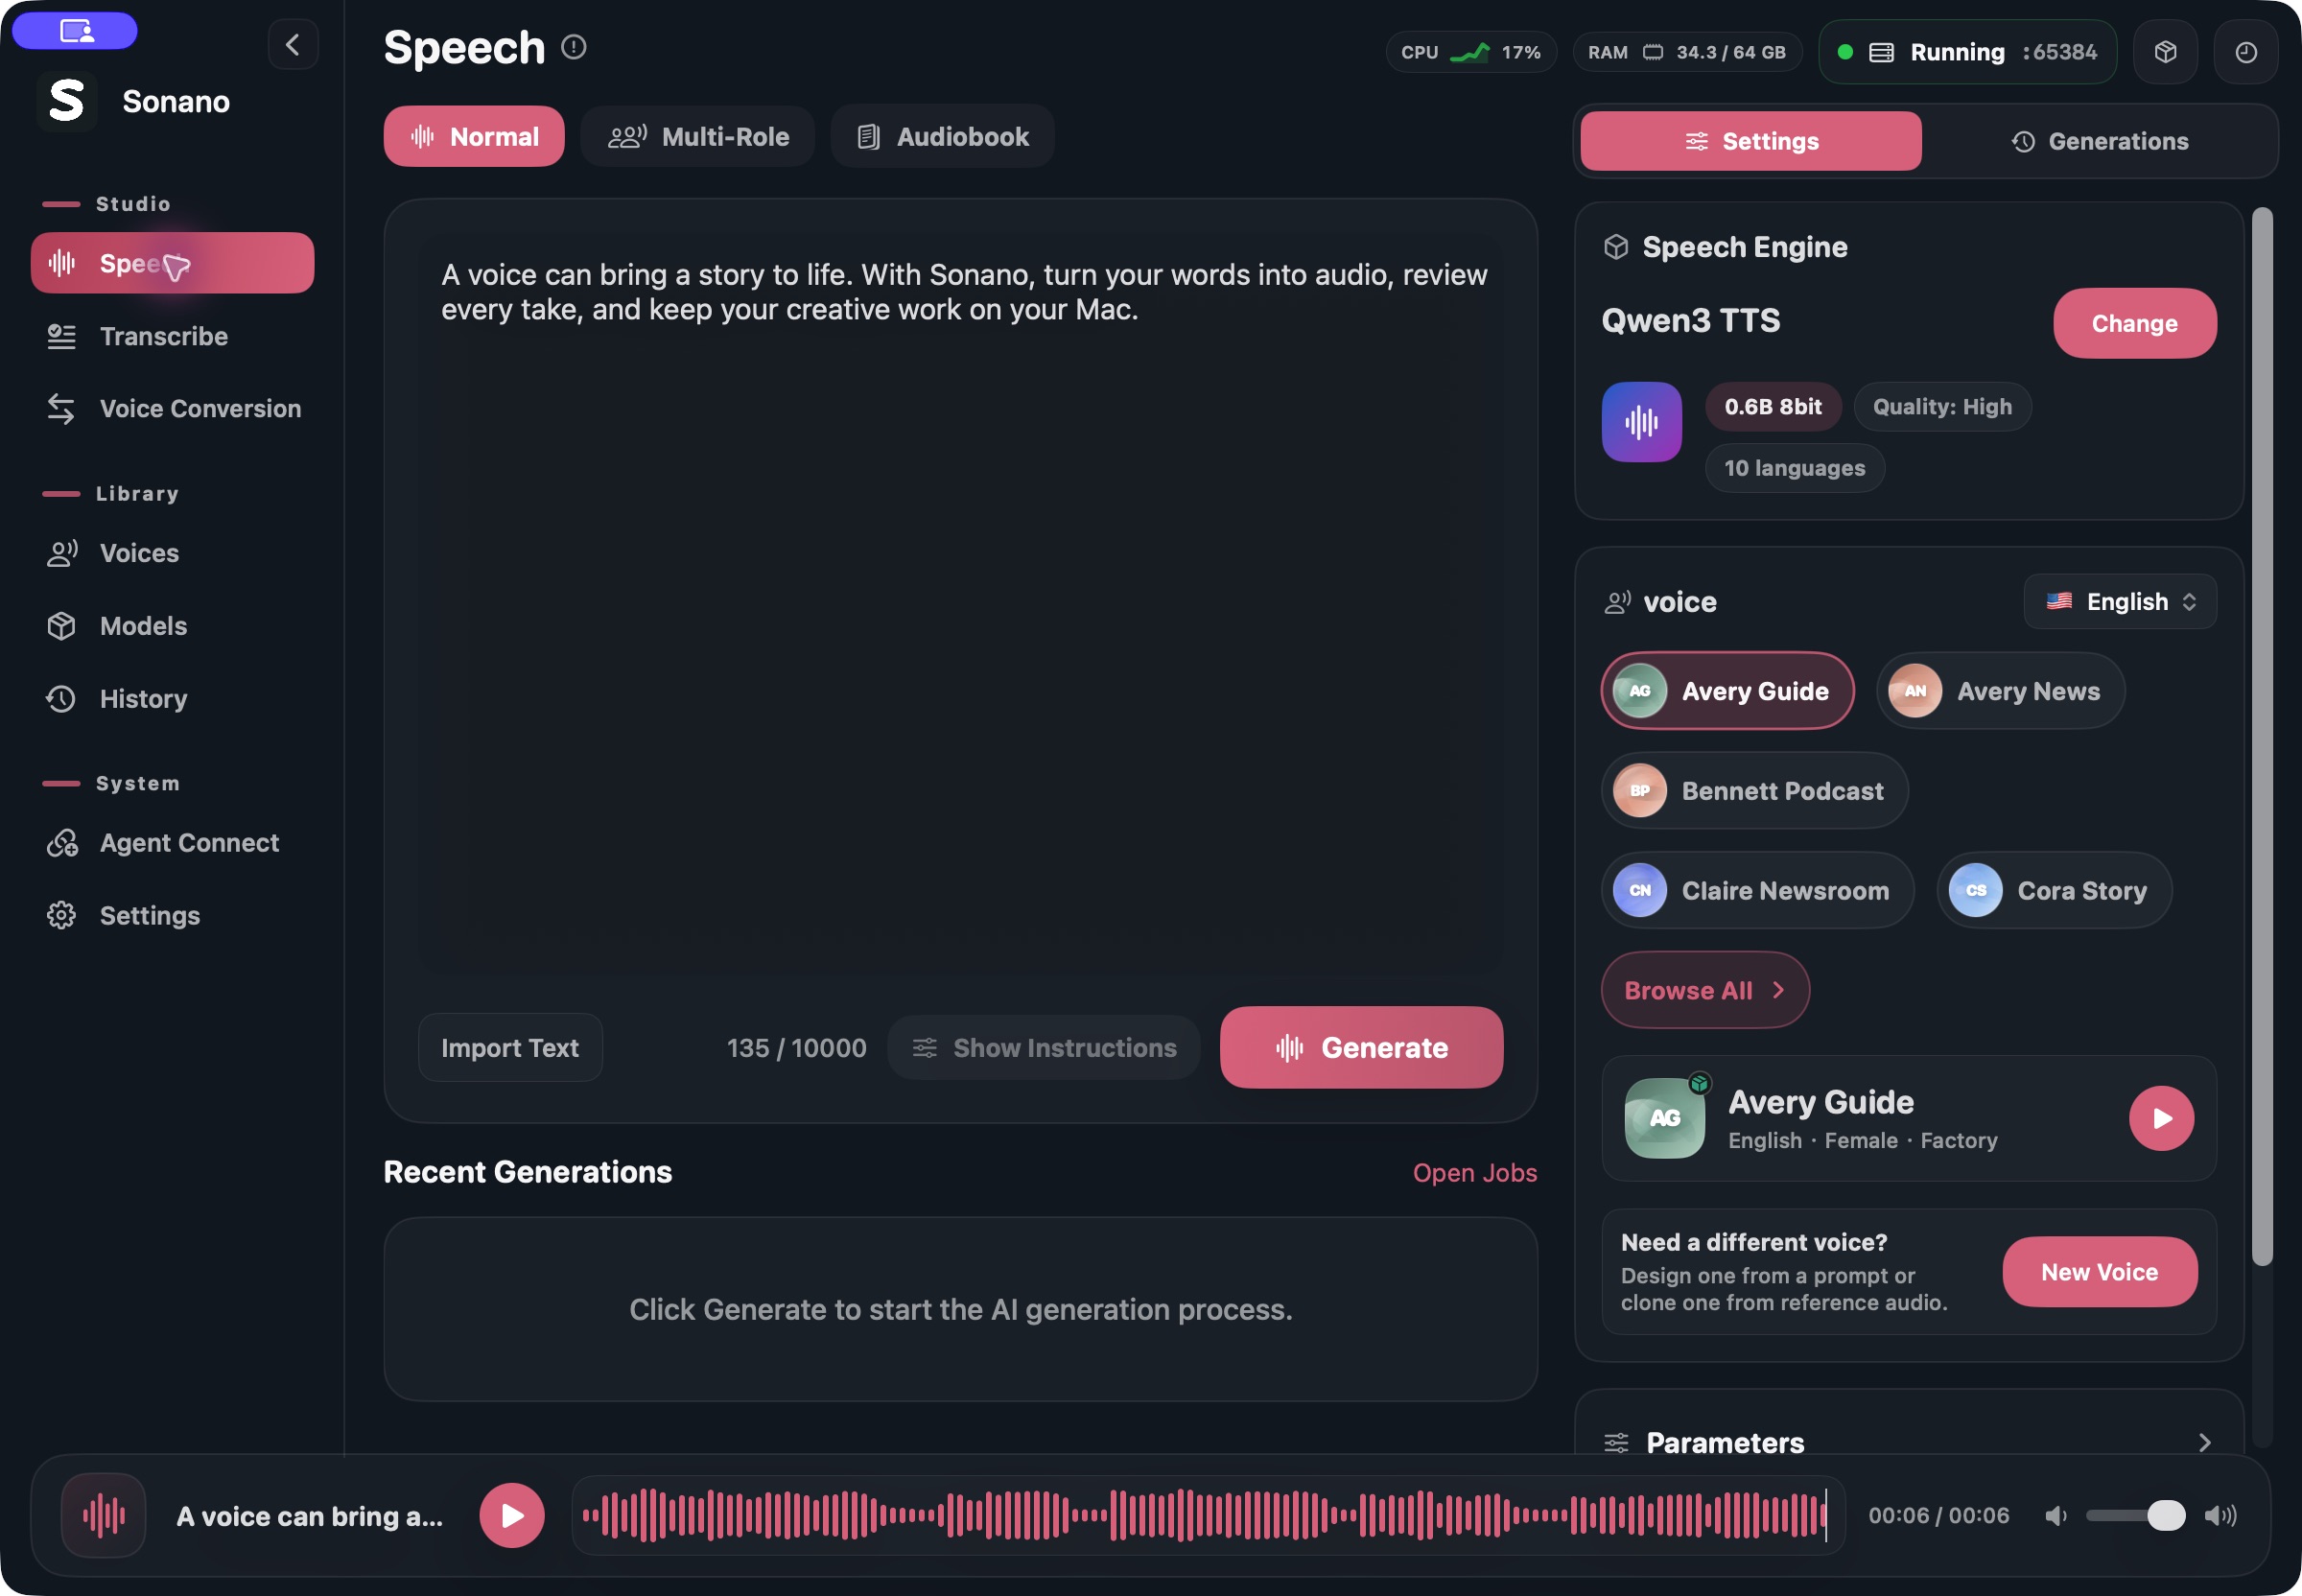
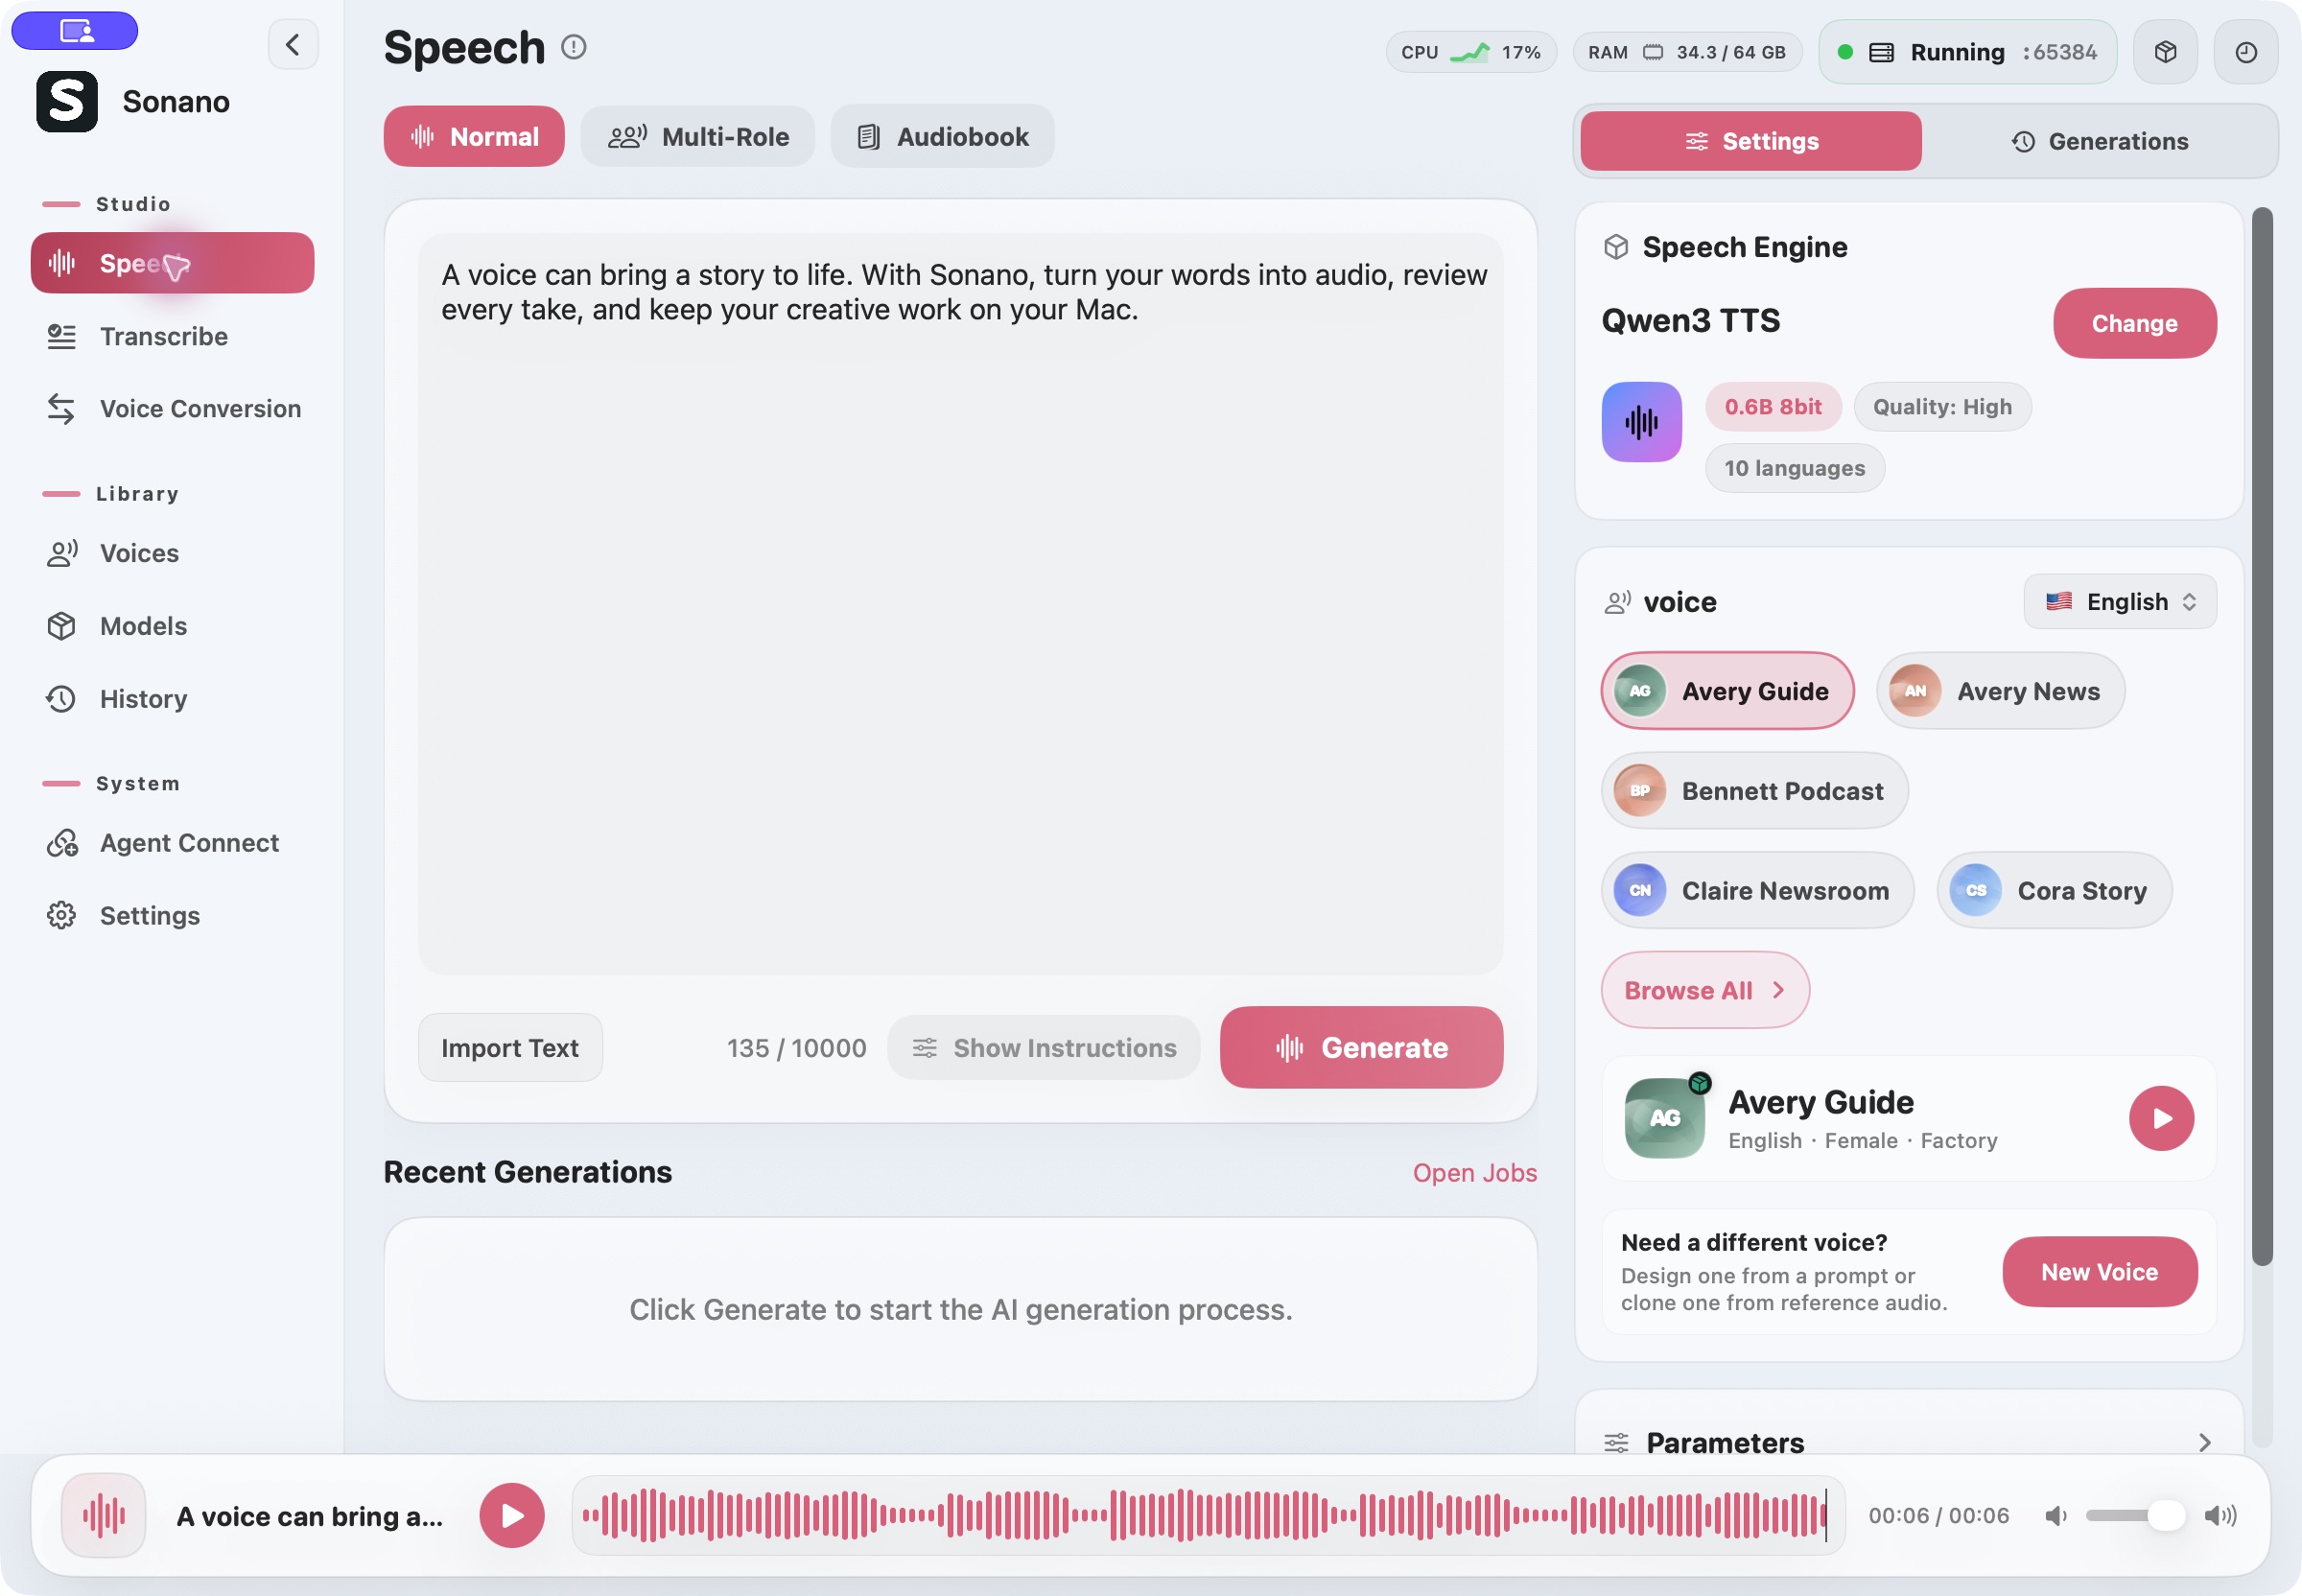
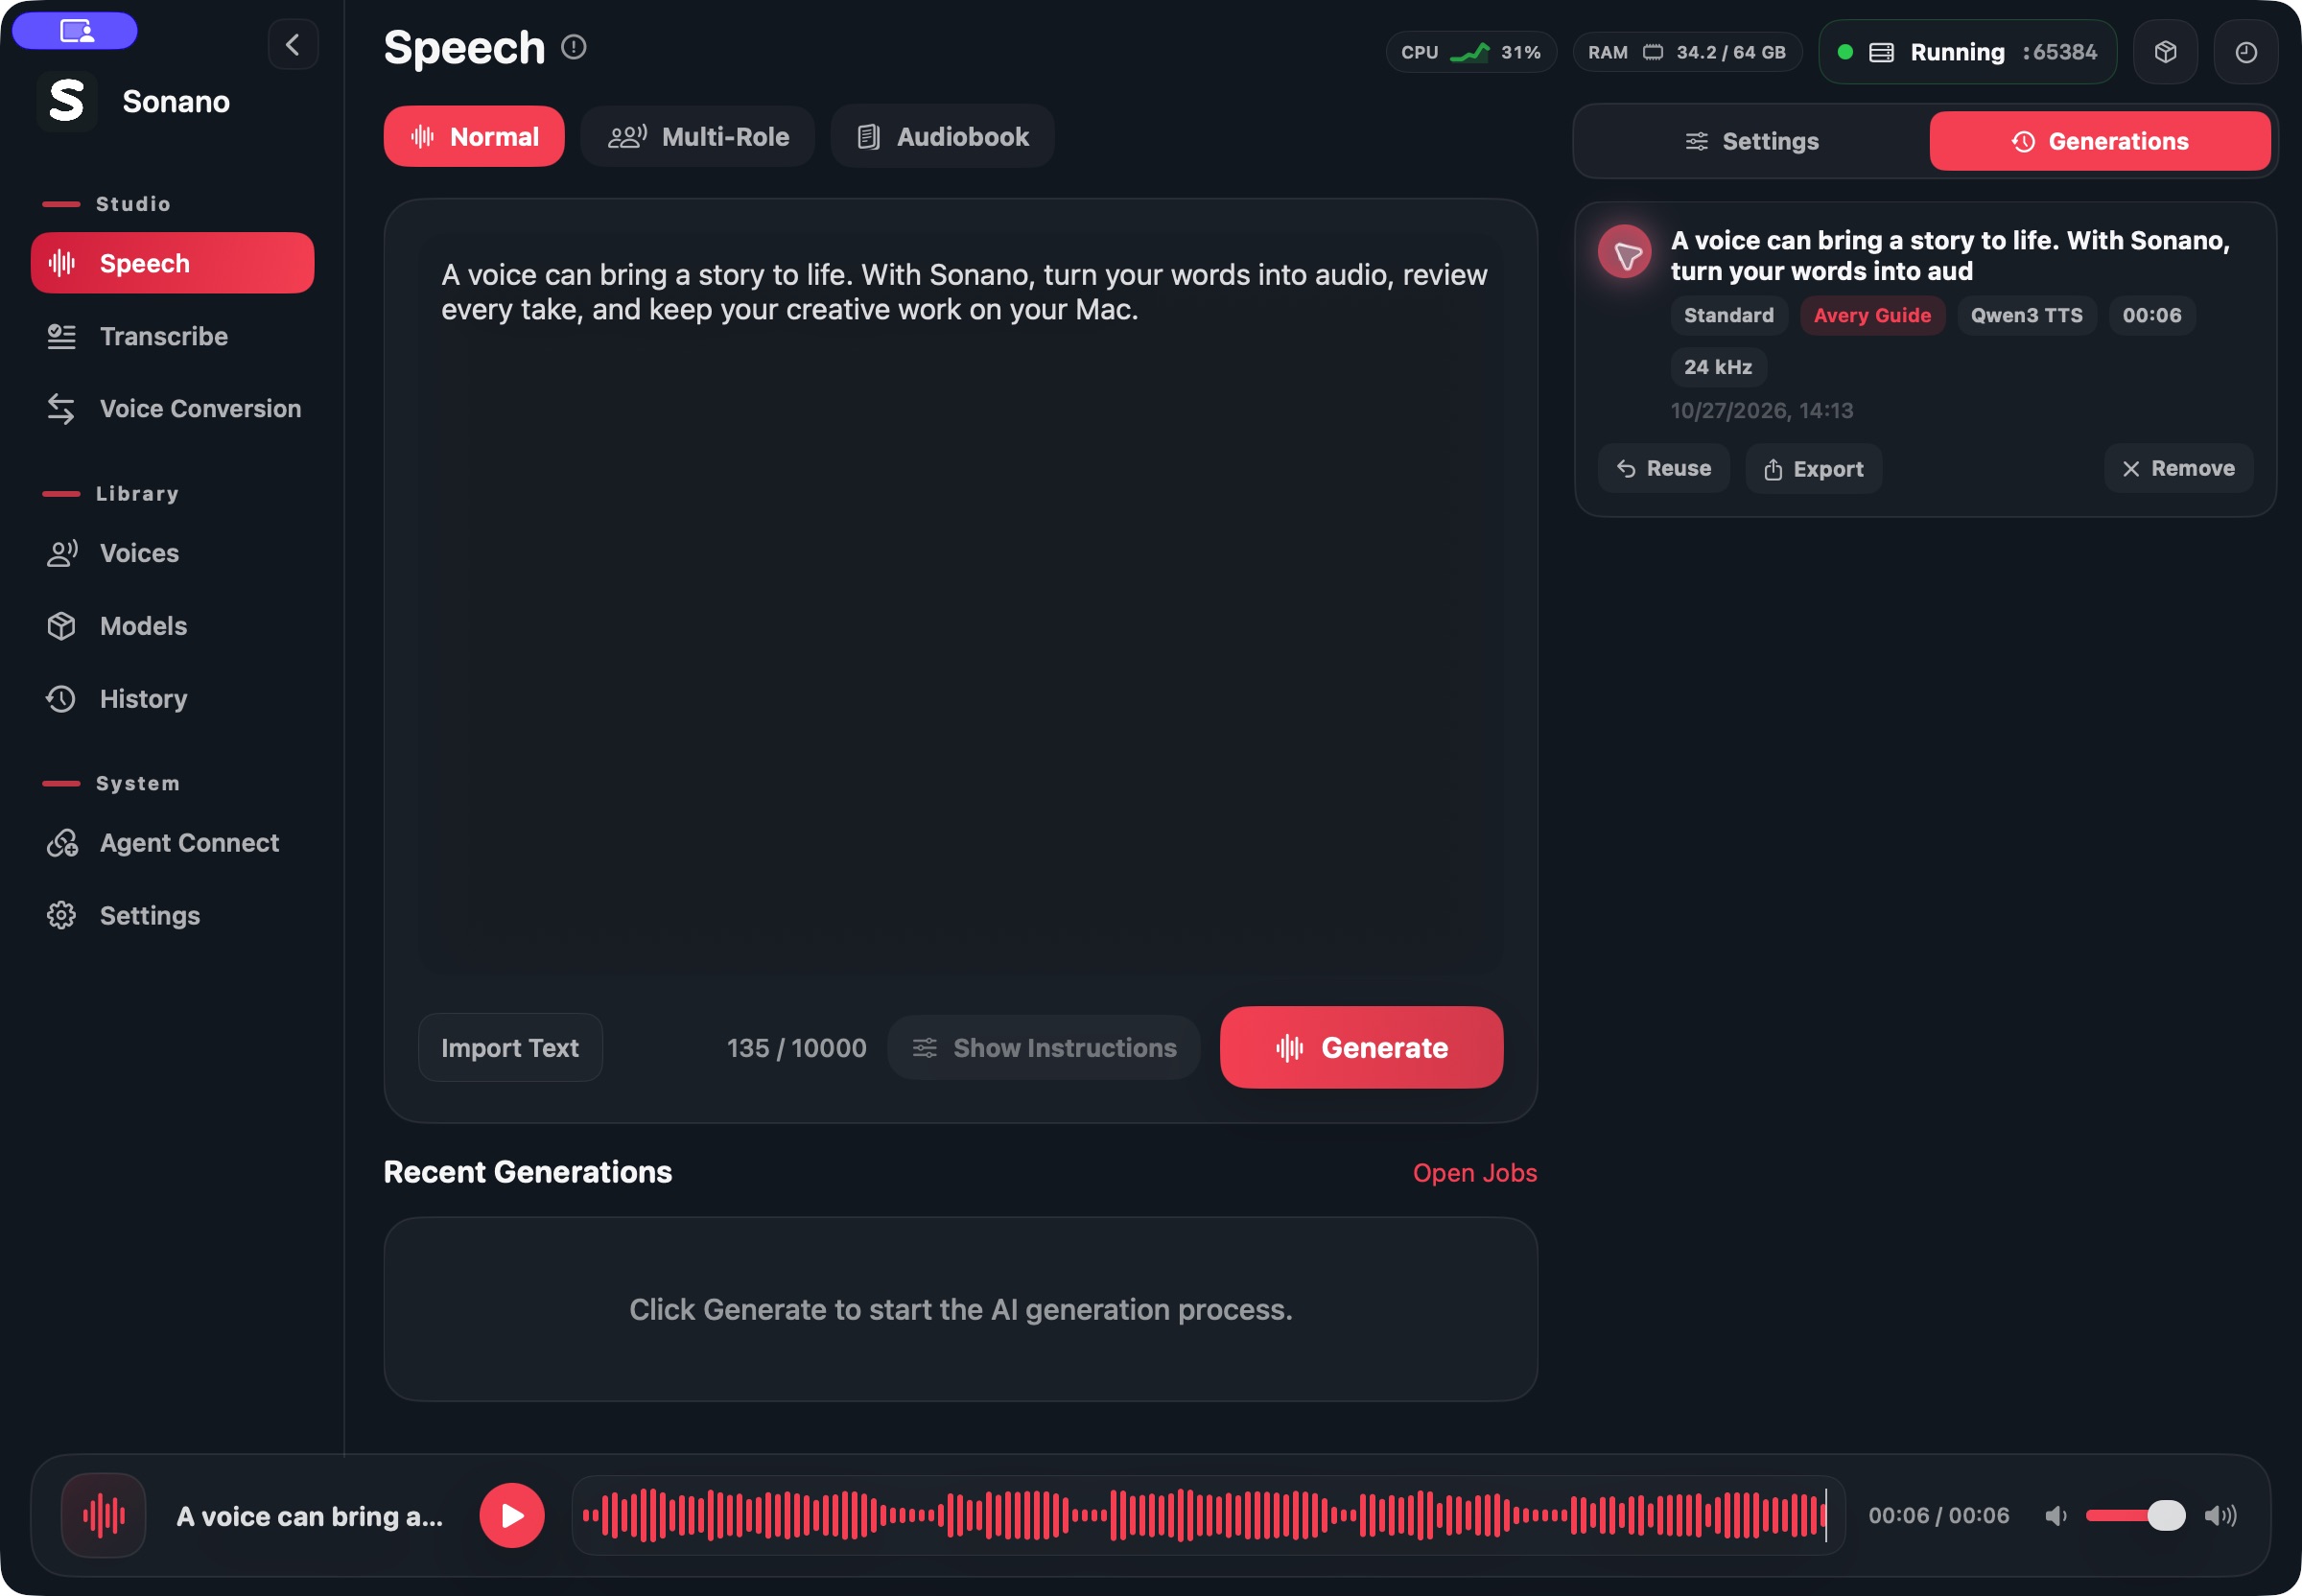
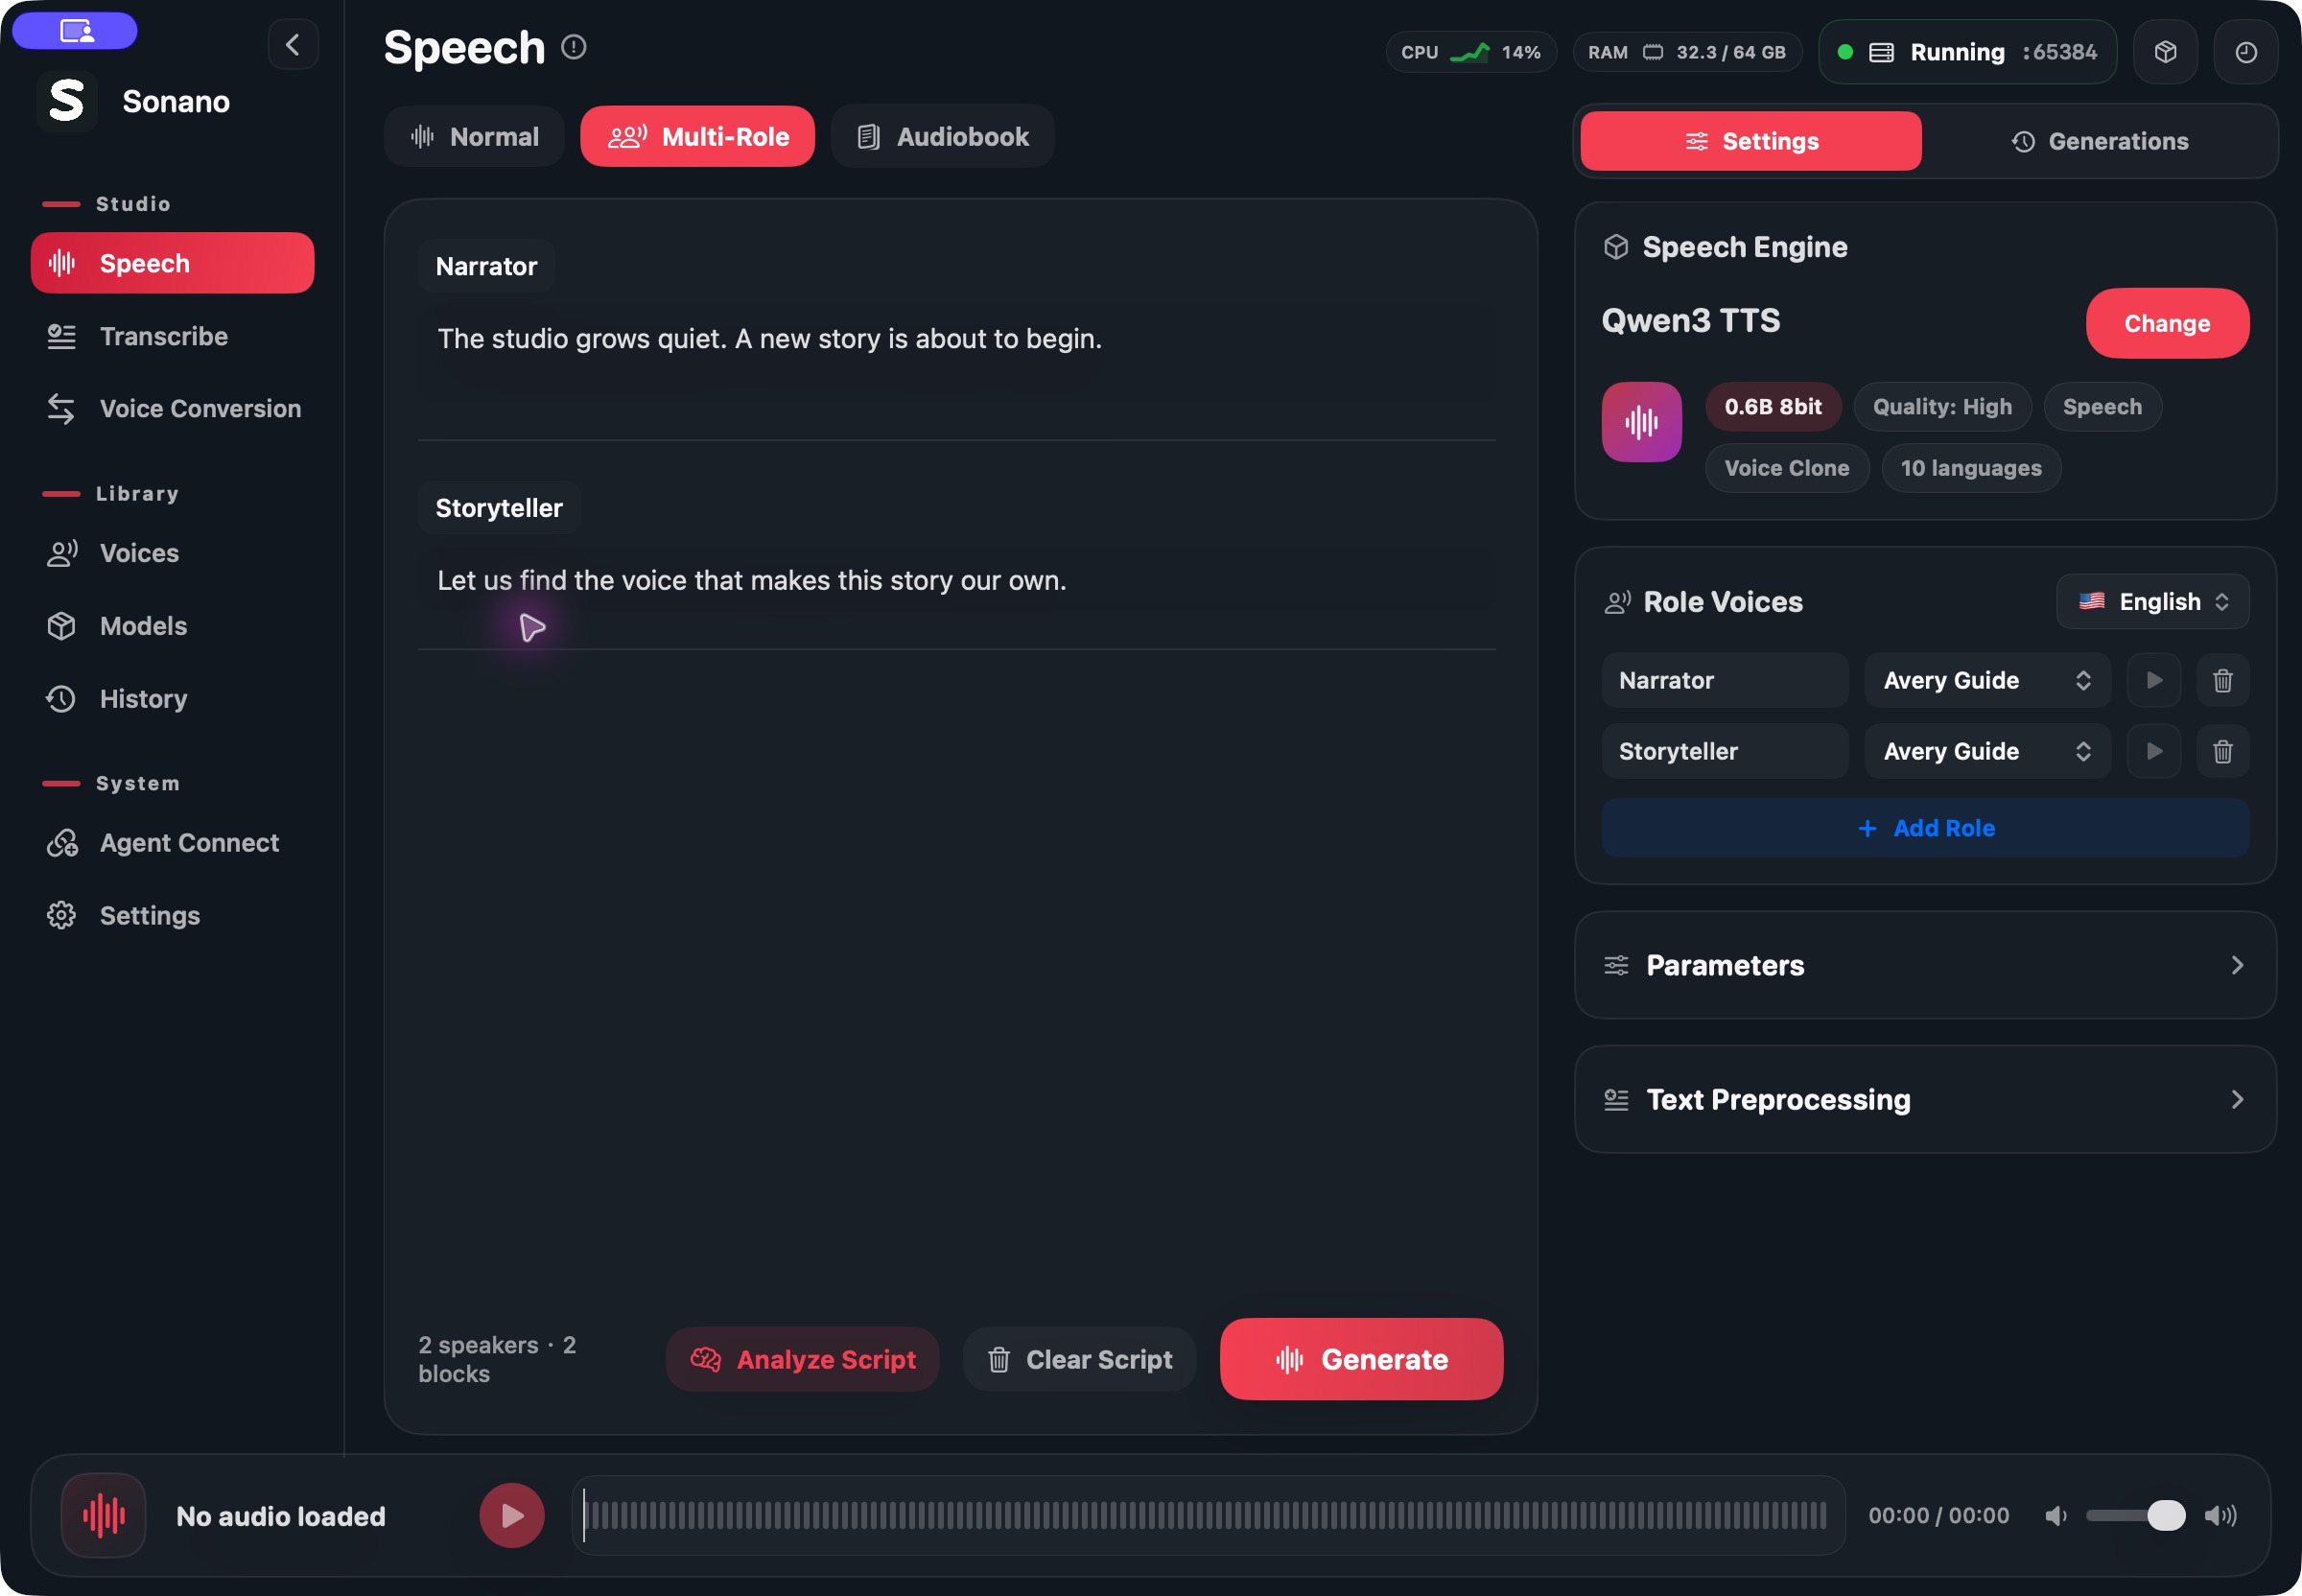
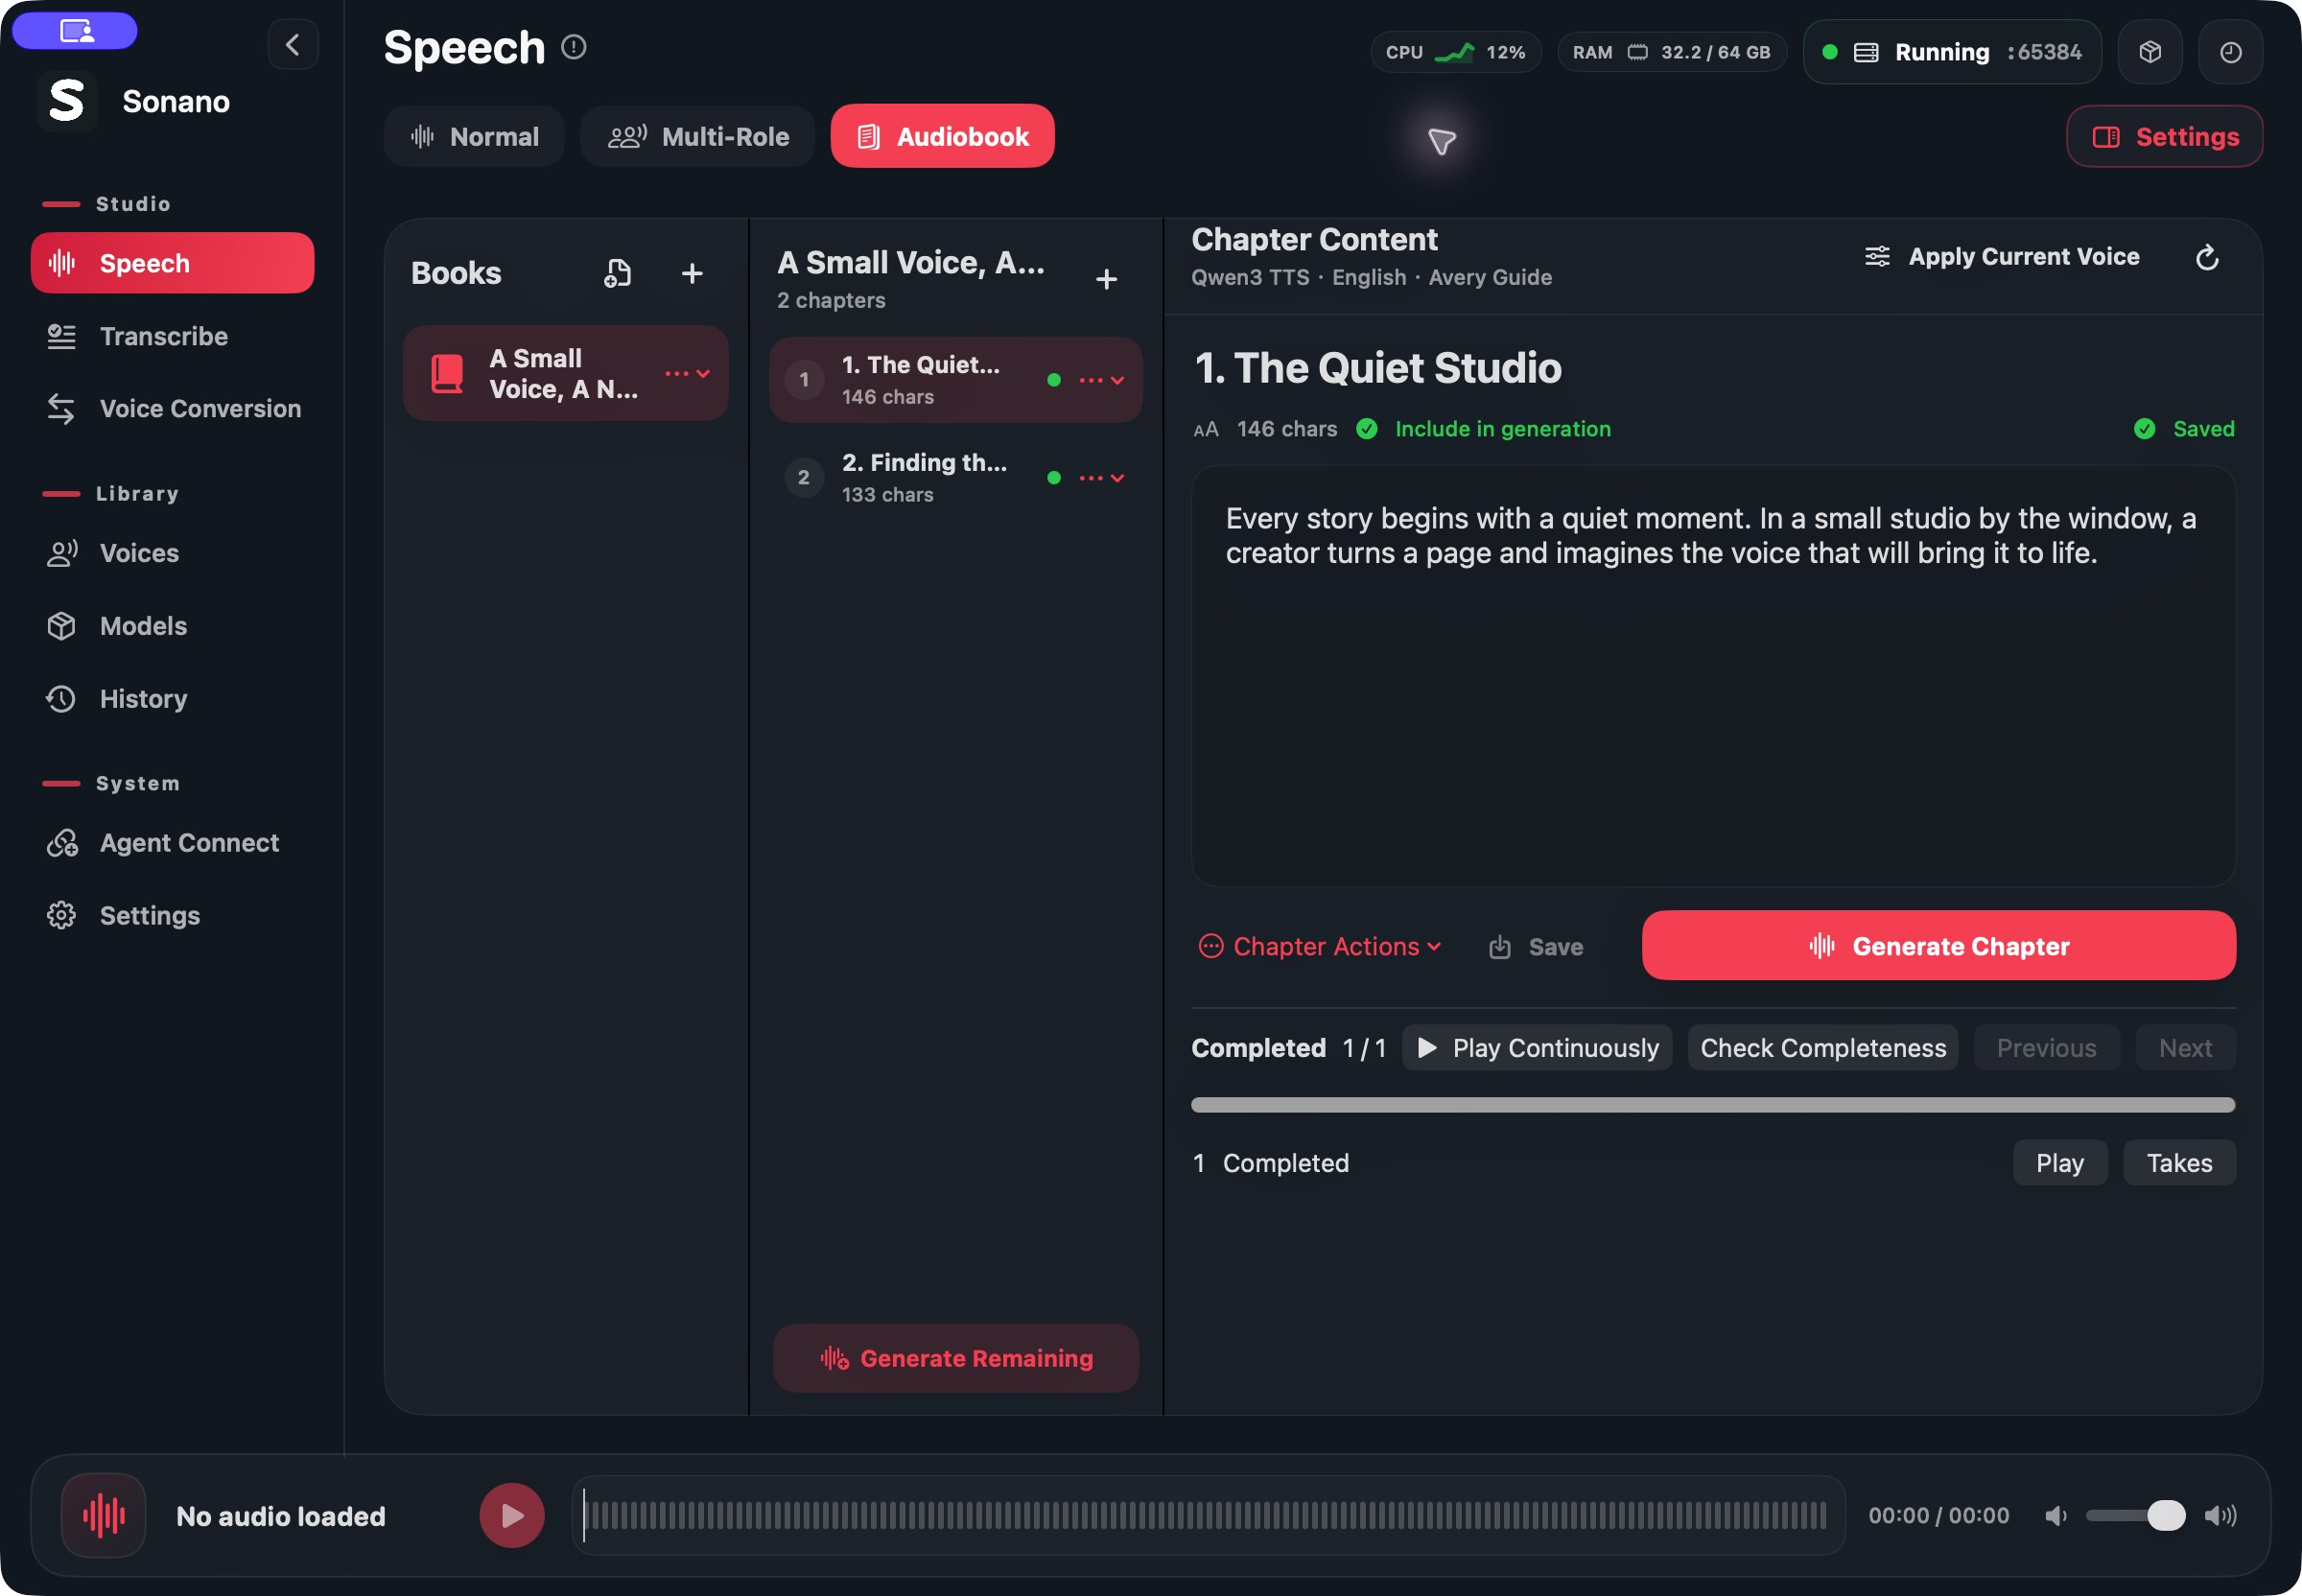
语音生成不只是单条 TTS,而是三种创作模式
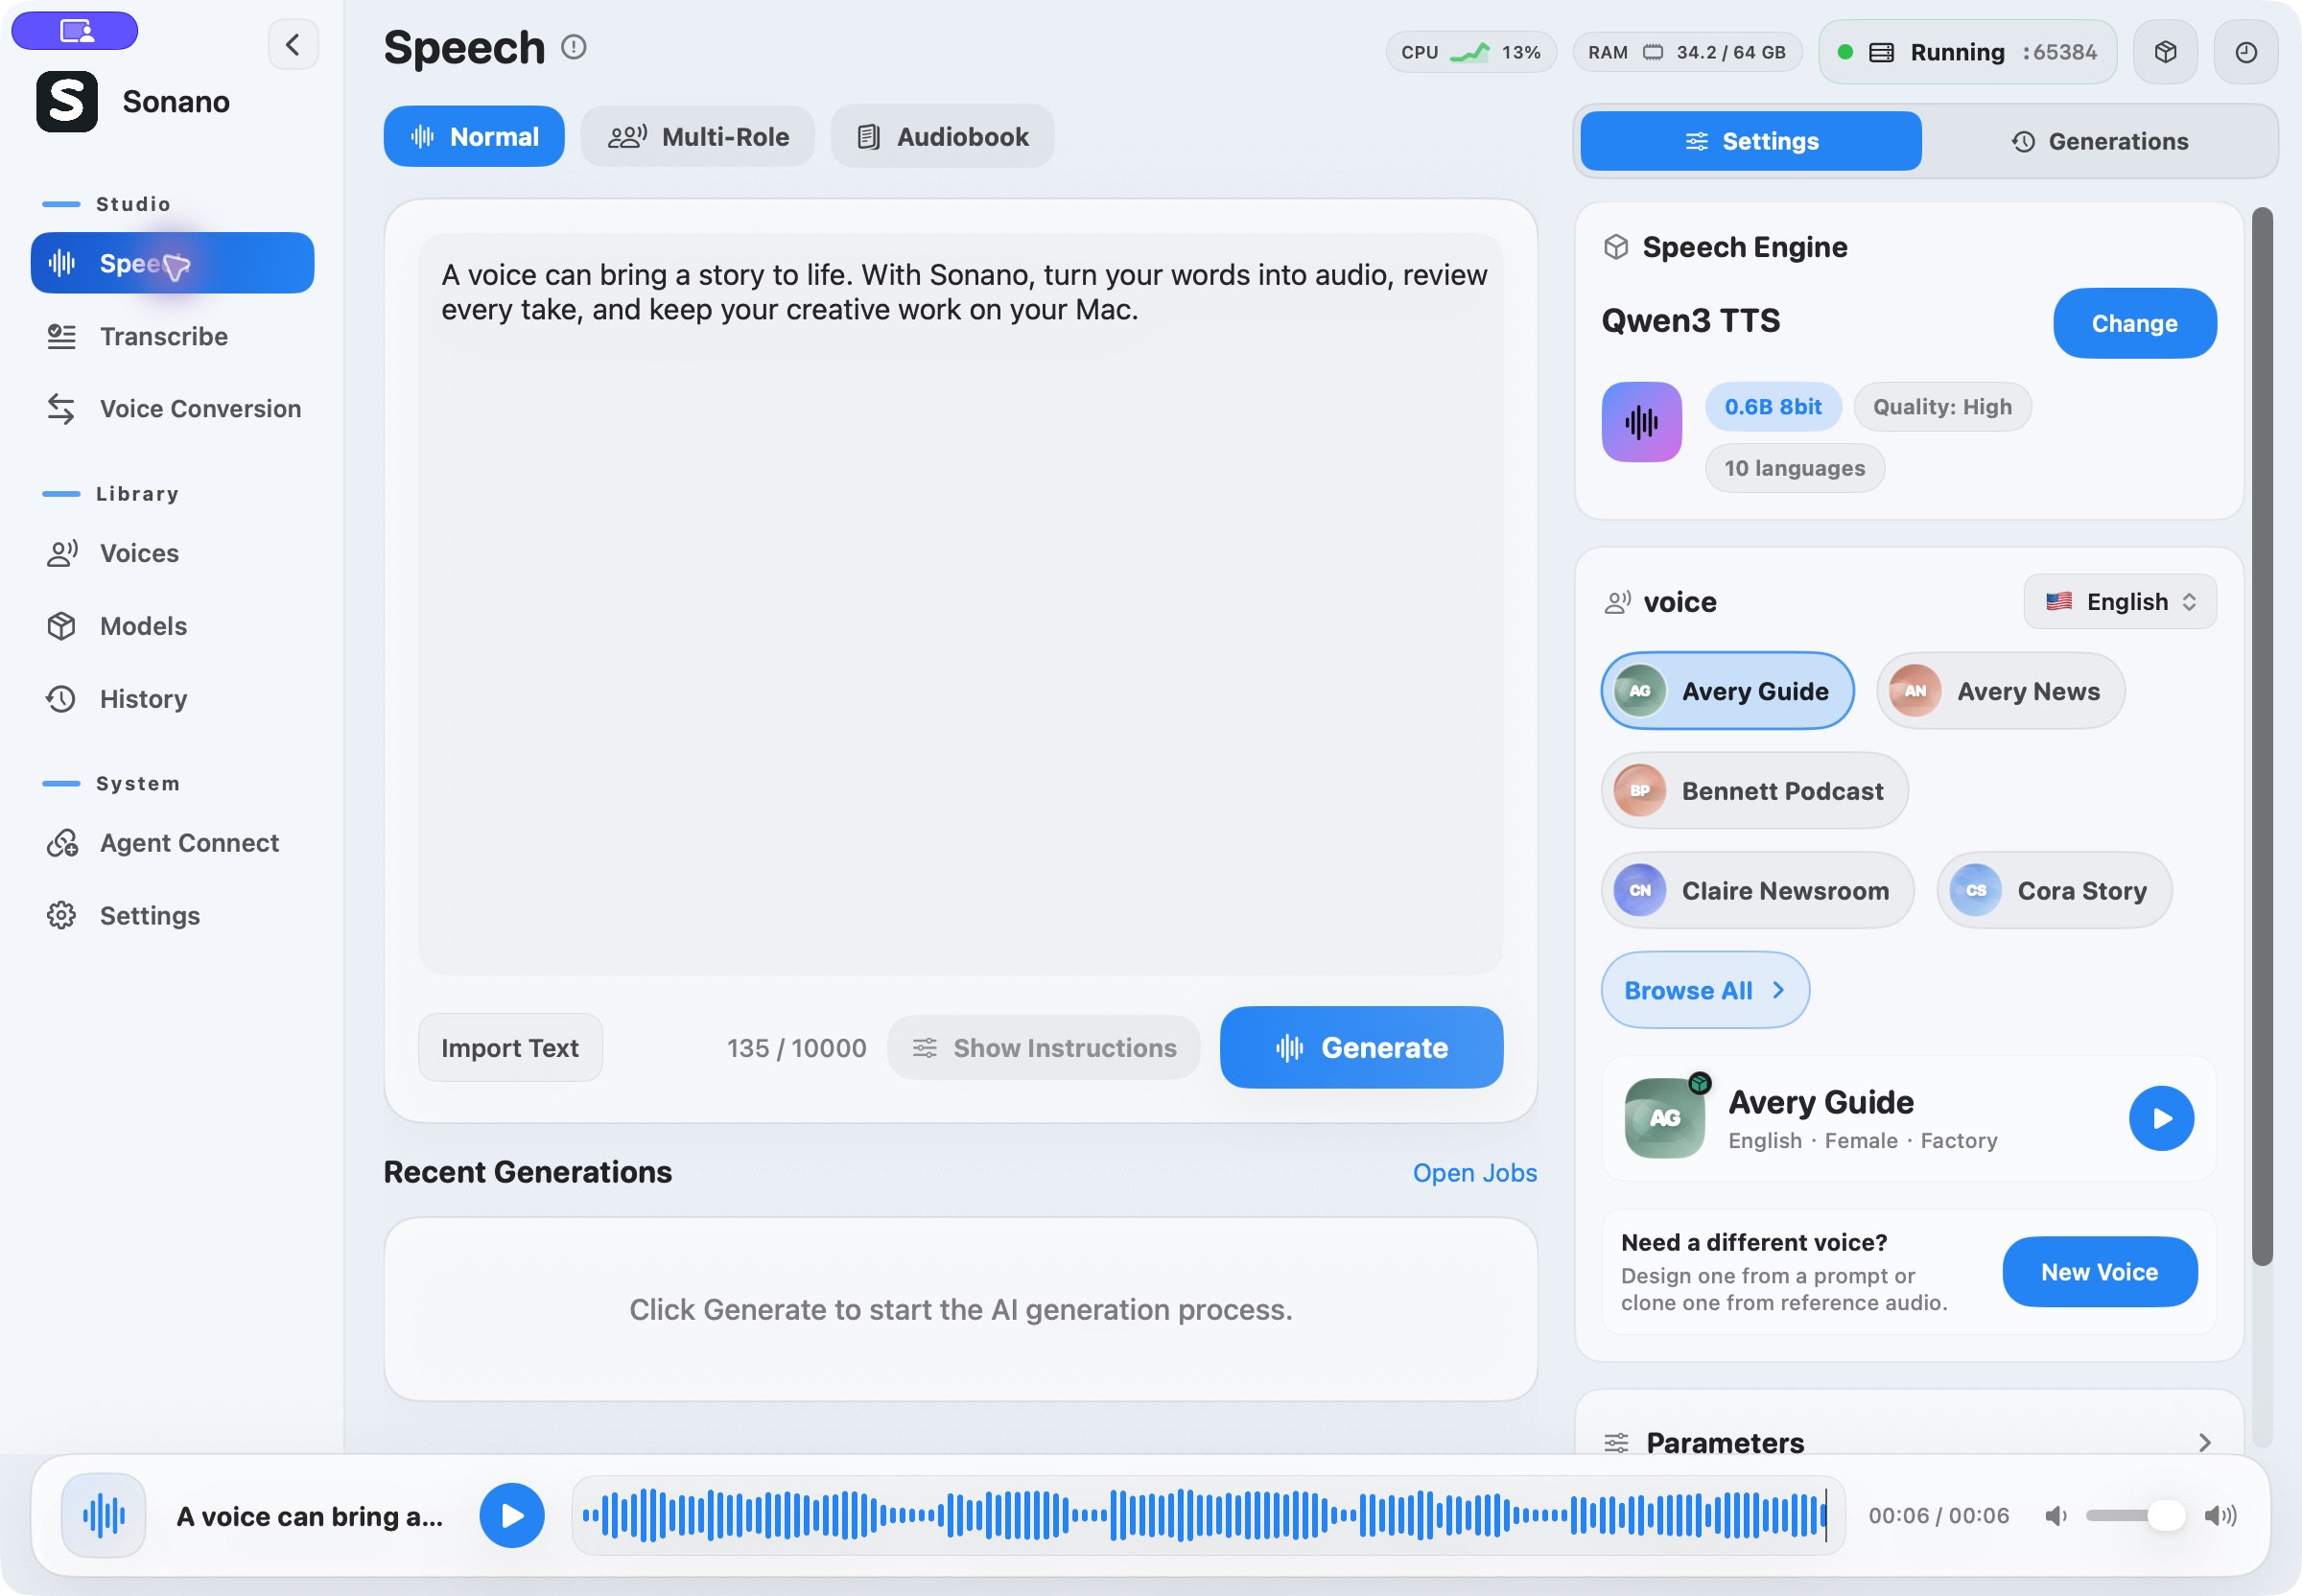
普通朗读、多角色脚本和有声书项目都在 Speech Studio 中完成。主路径始终围绕“模型 -> 输出语言 -> 声音”,生成结果进入同一套播放器、历史、导出和产物系统。
- 普通模式:短文案、口播、长文本自动分段和快速试听
- 多角色模式:AI 分析脚本、角色声音映射和单段重生成
- 有声书模式:导入 EPUB / TXT / Markdown,按章节生成并合并导出
产品导览
Sonano 把语音生成、转写、声音库、声音转换、模型、任务、历史和 Agent 接入放在同一条本地生产线上。用户不需要在零散工具之间搬运文件,也不需要让自动化调用变成看不见的后台黑箱。
桌面外观
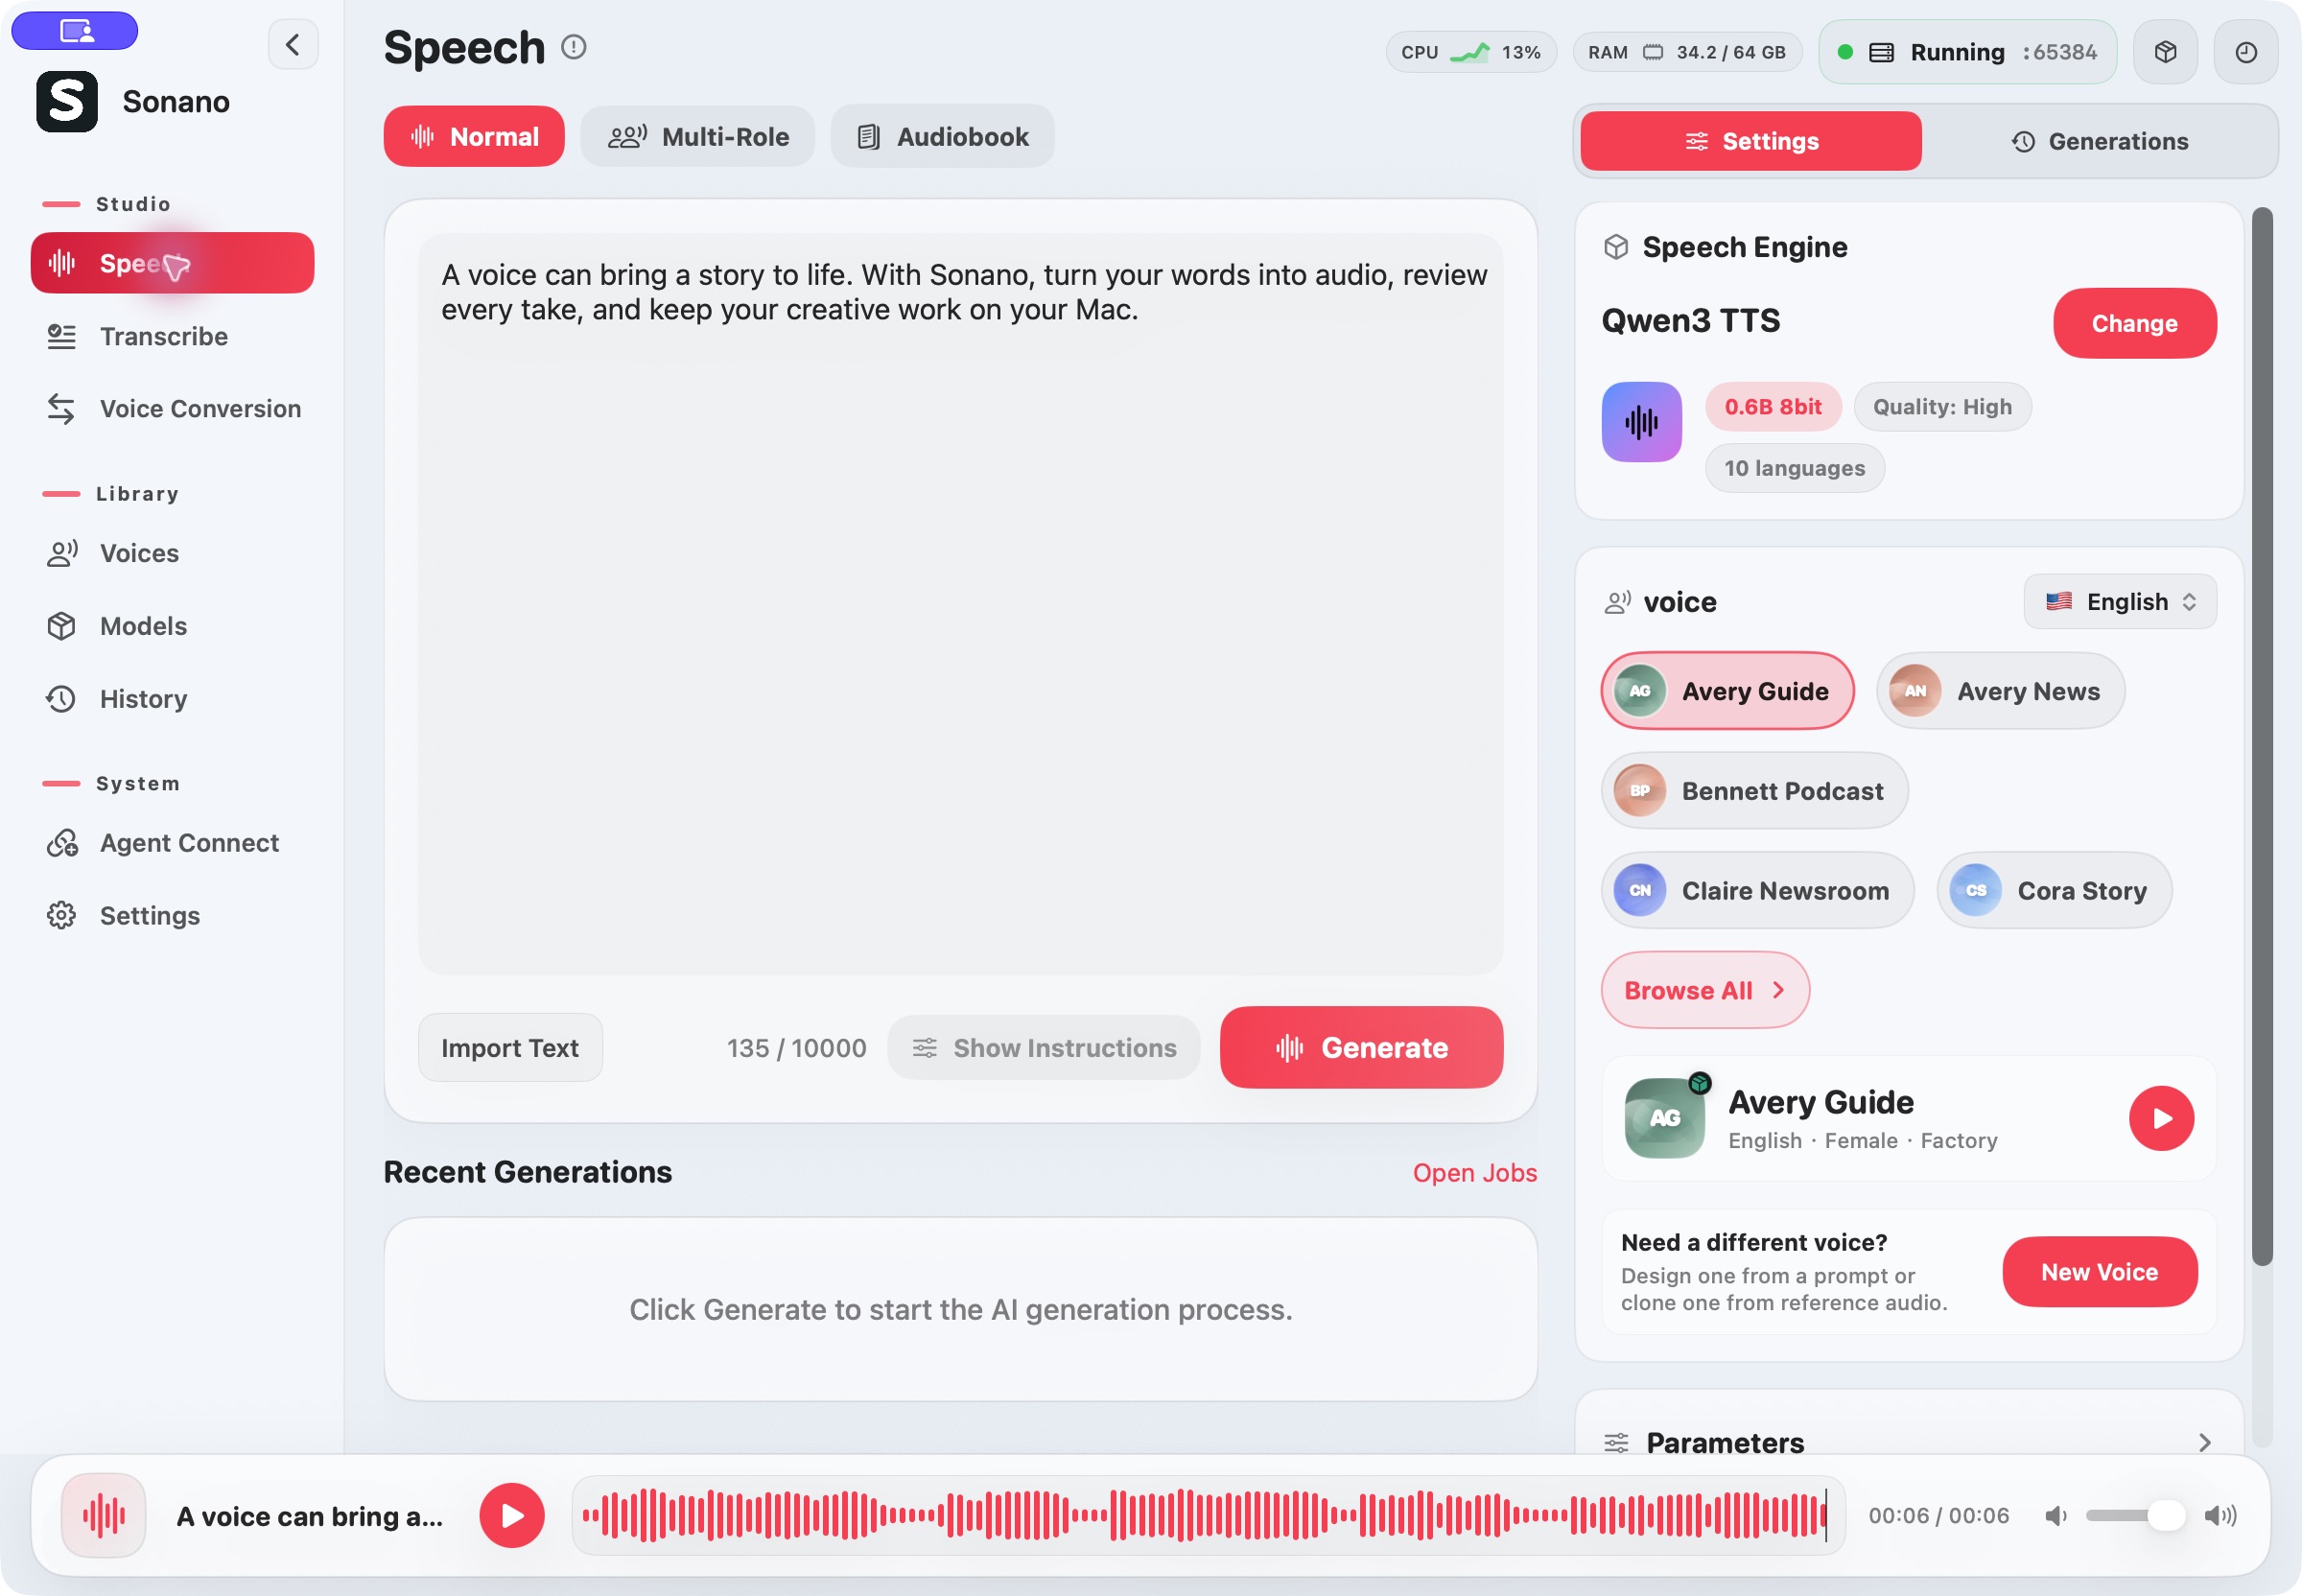
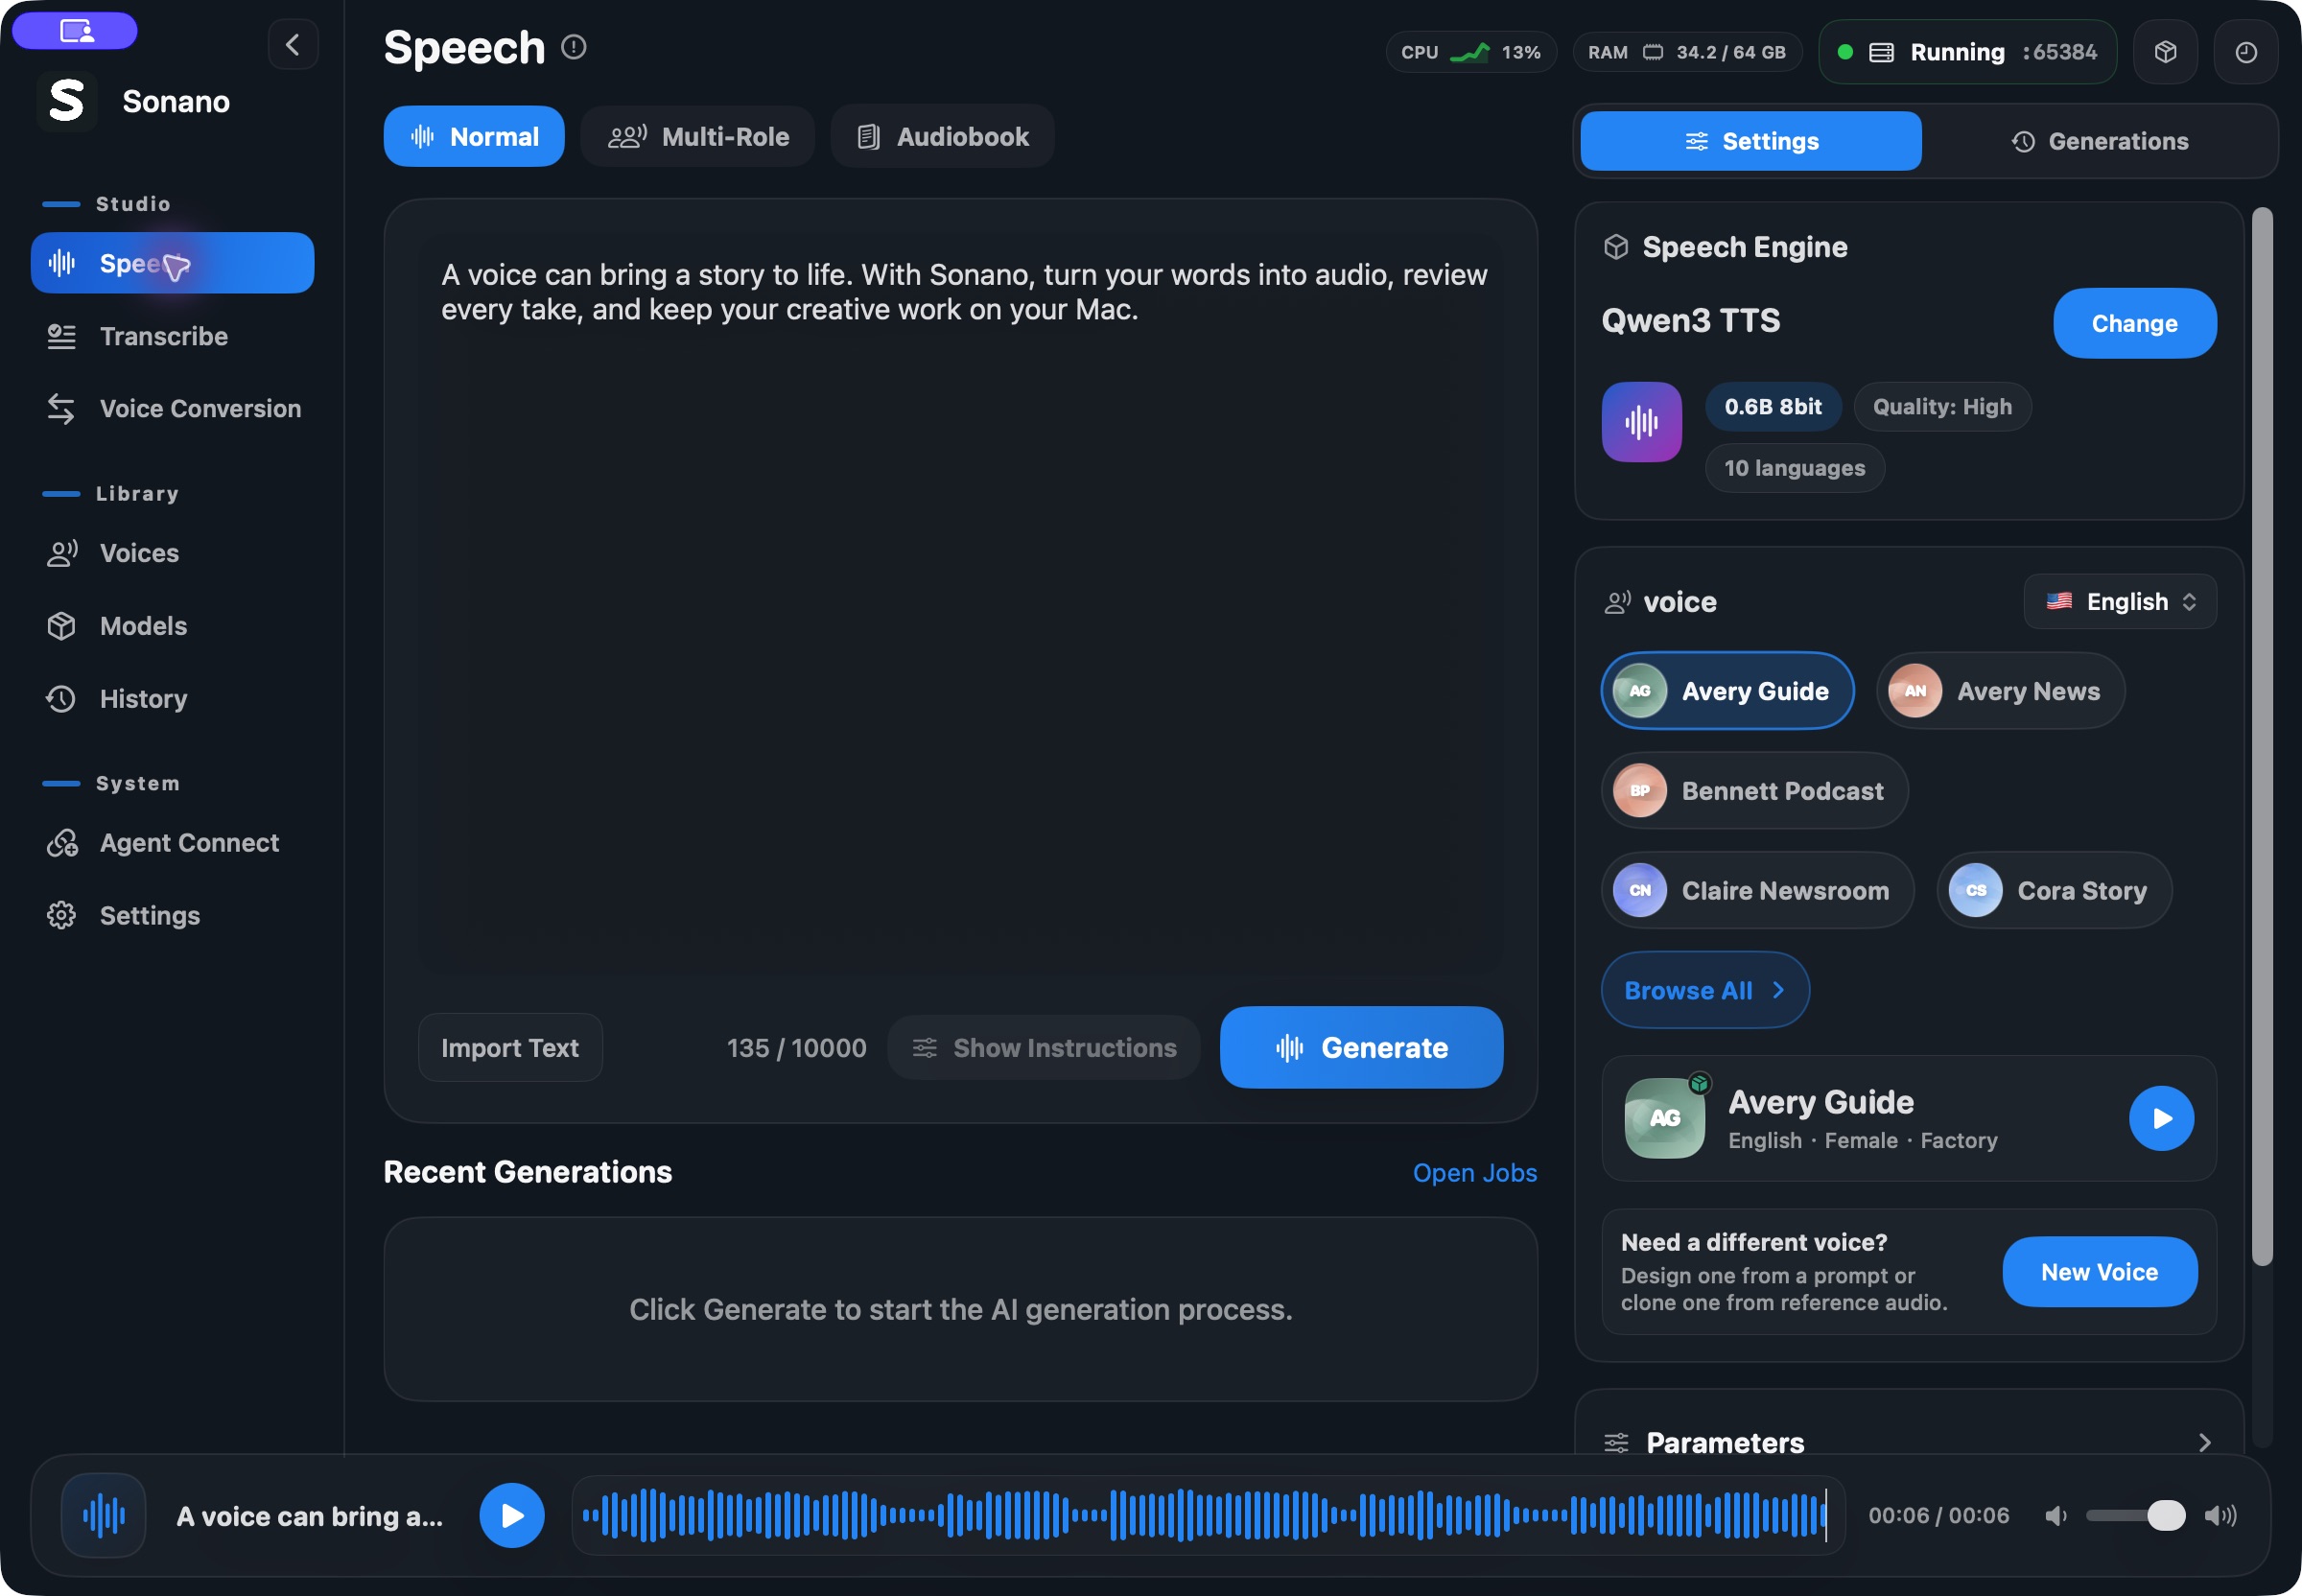
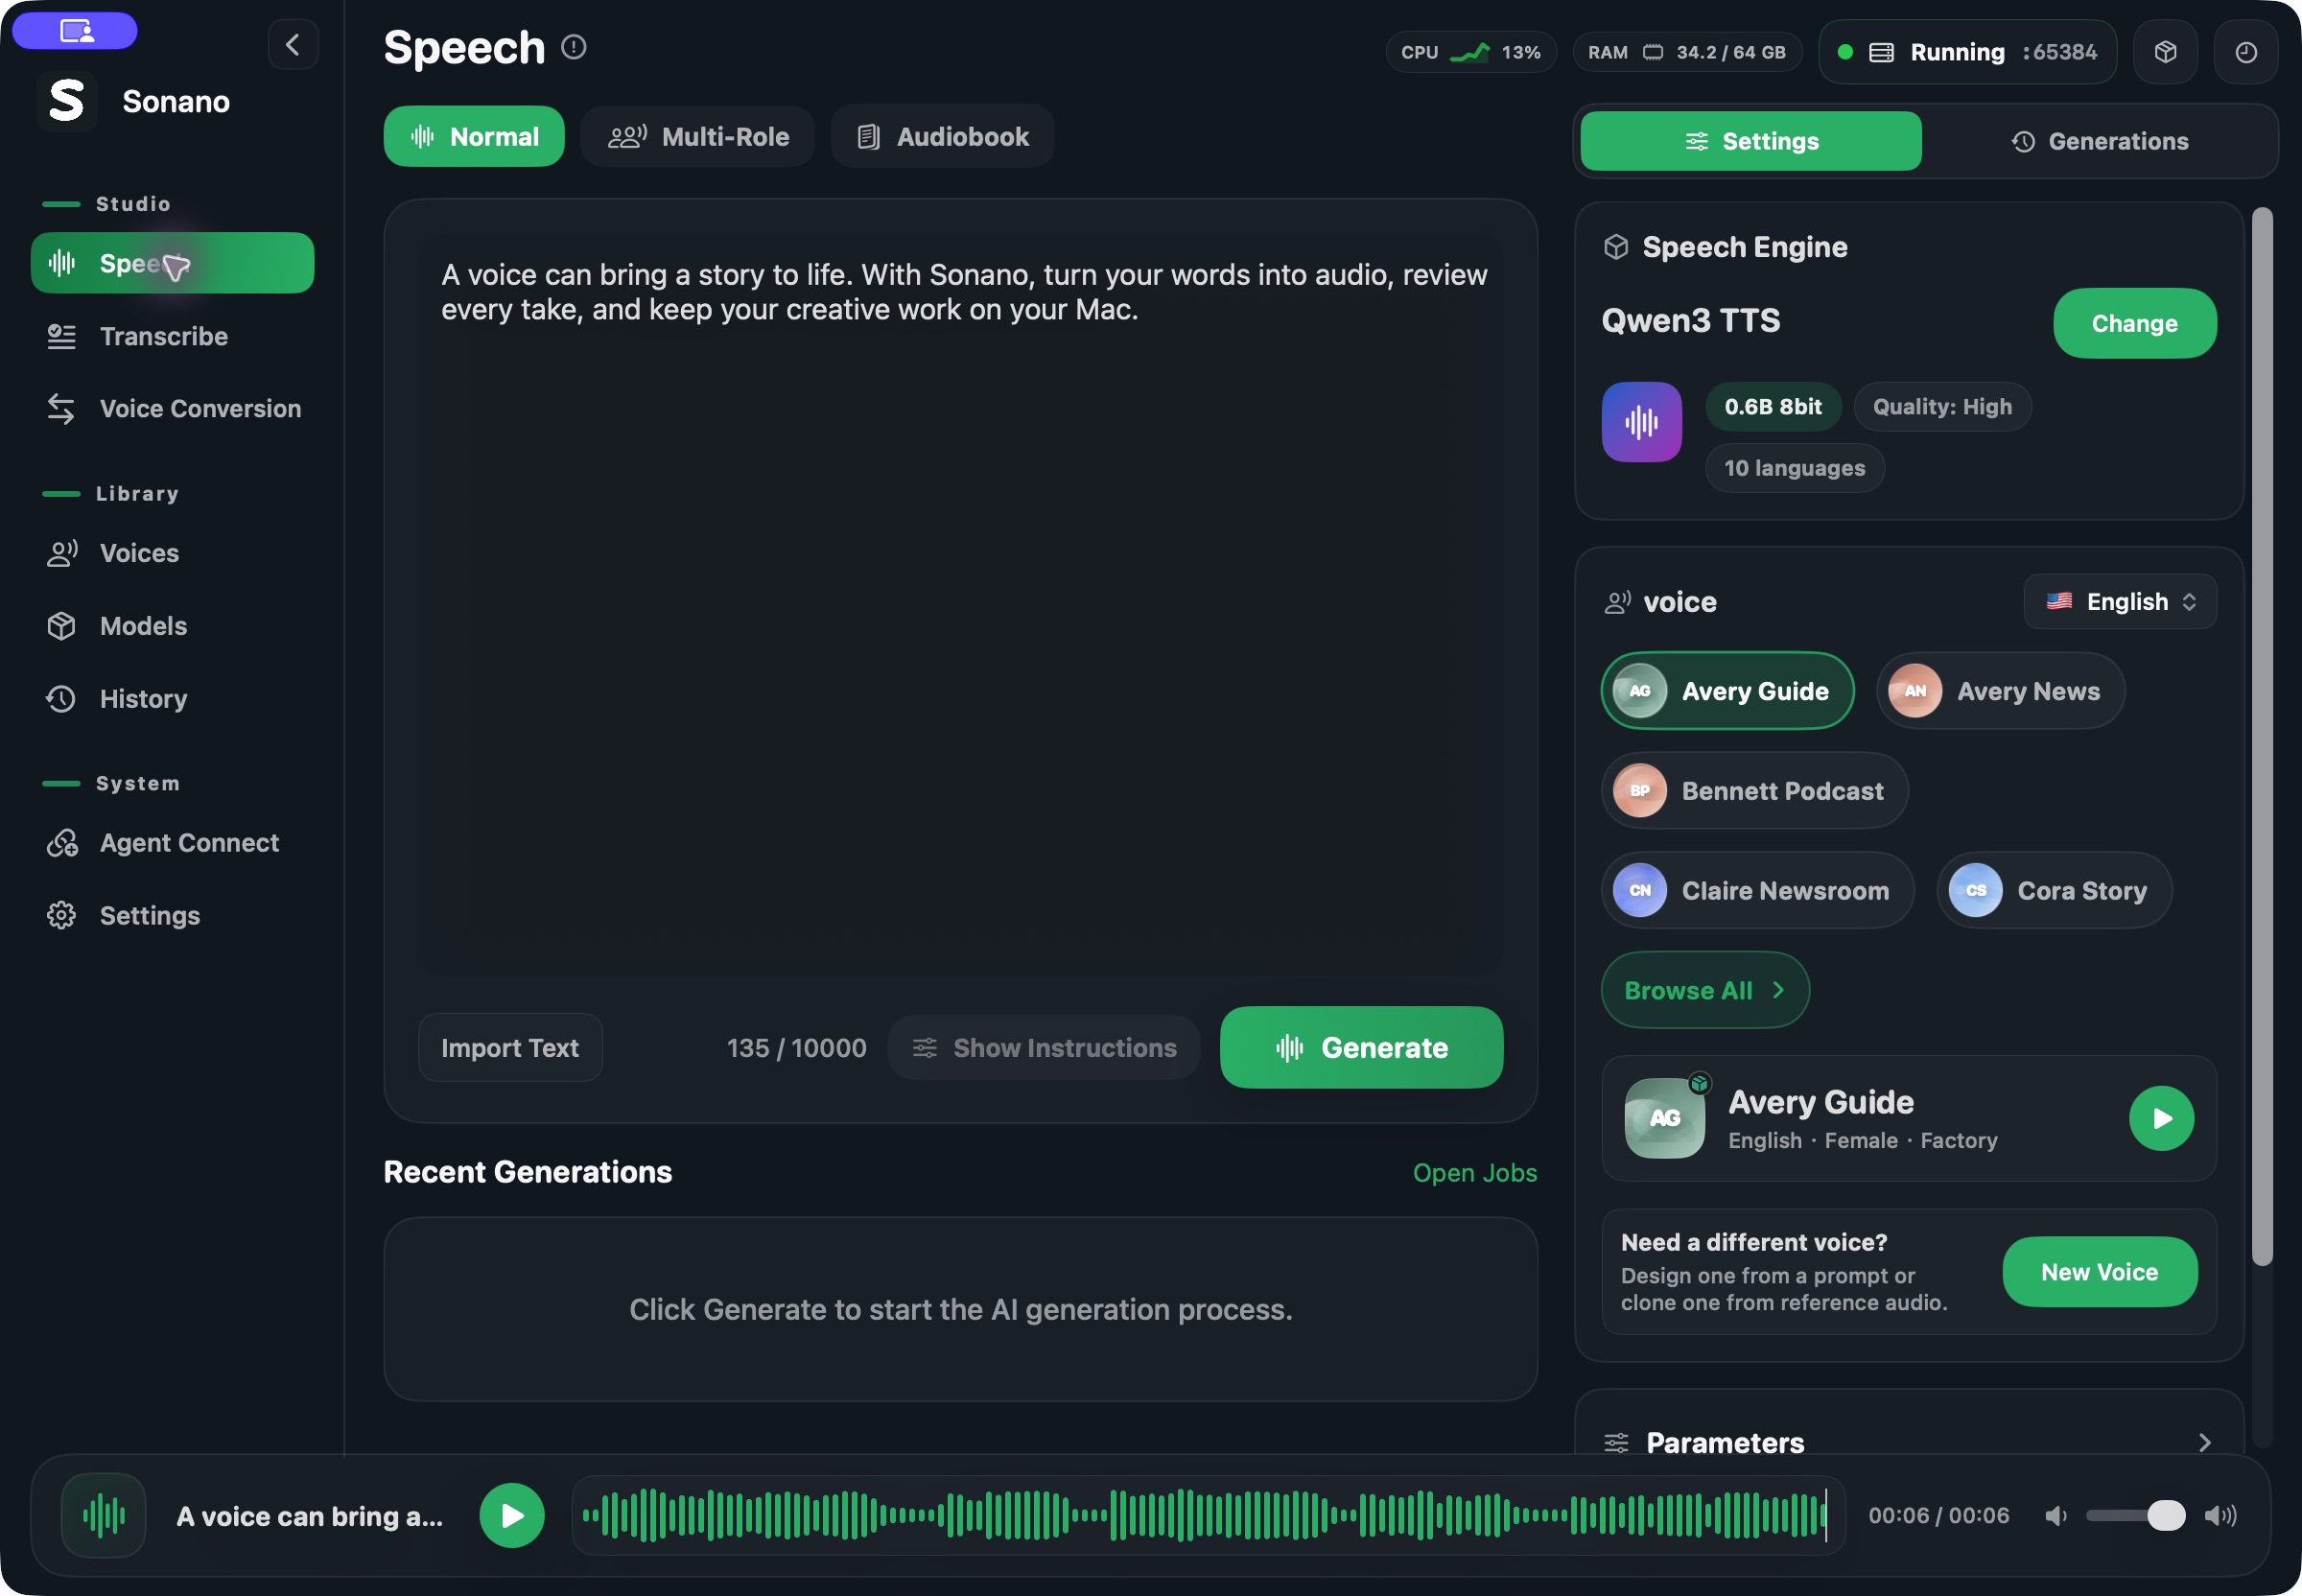
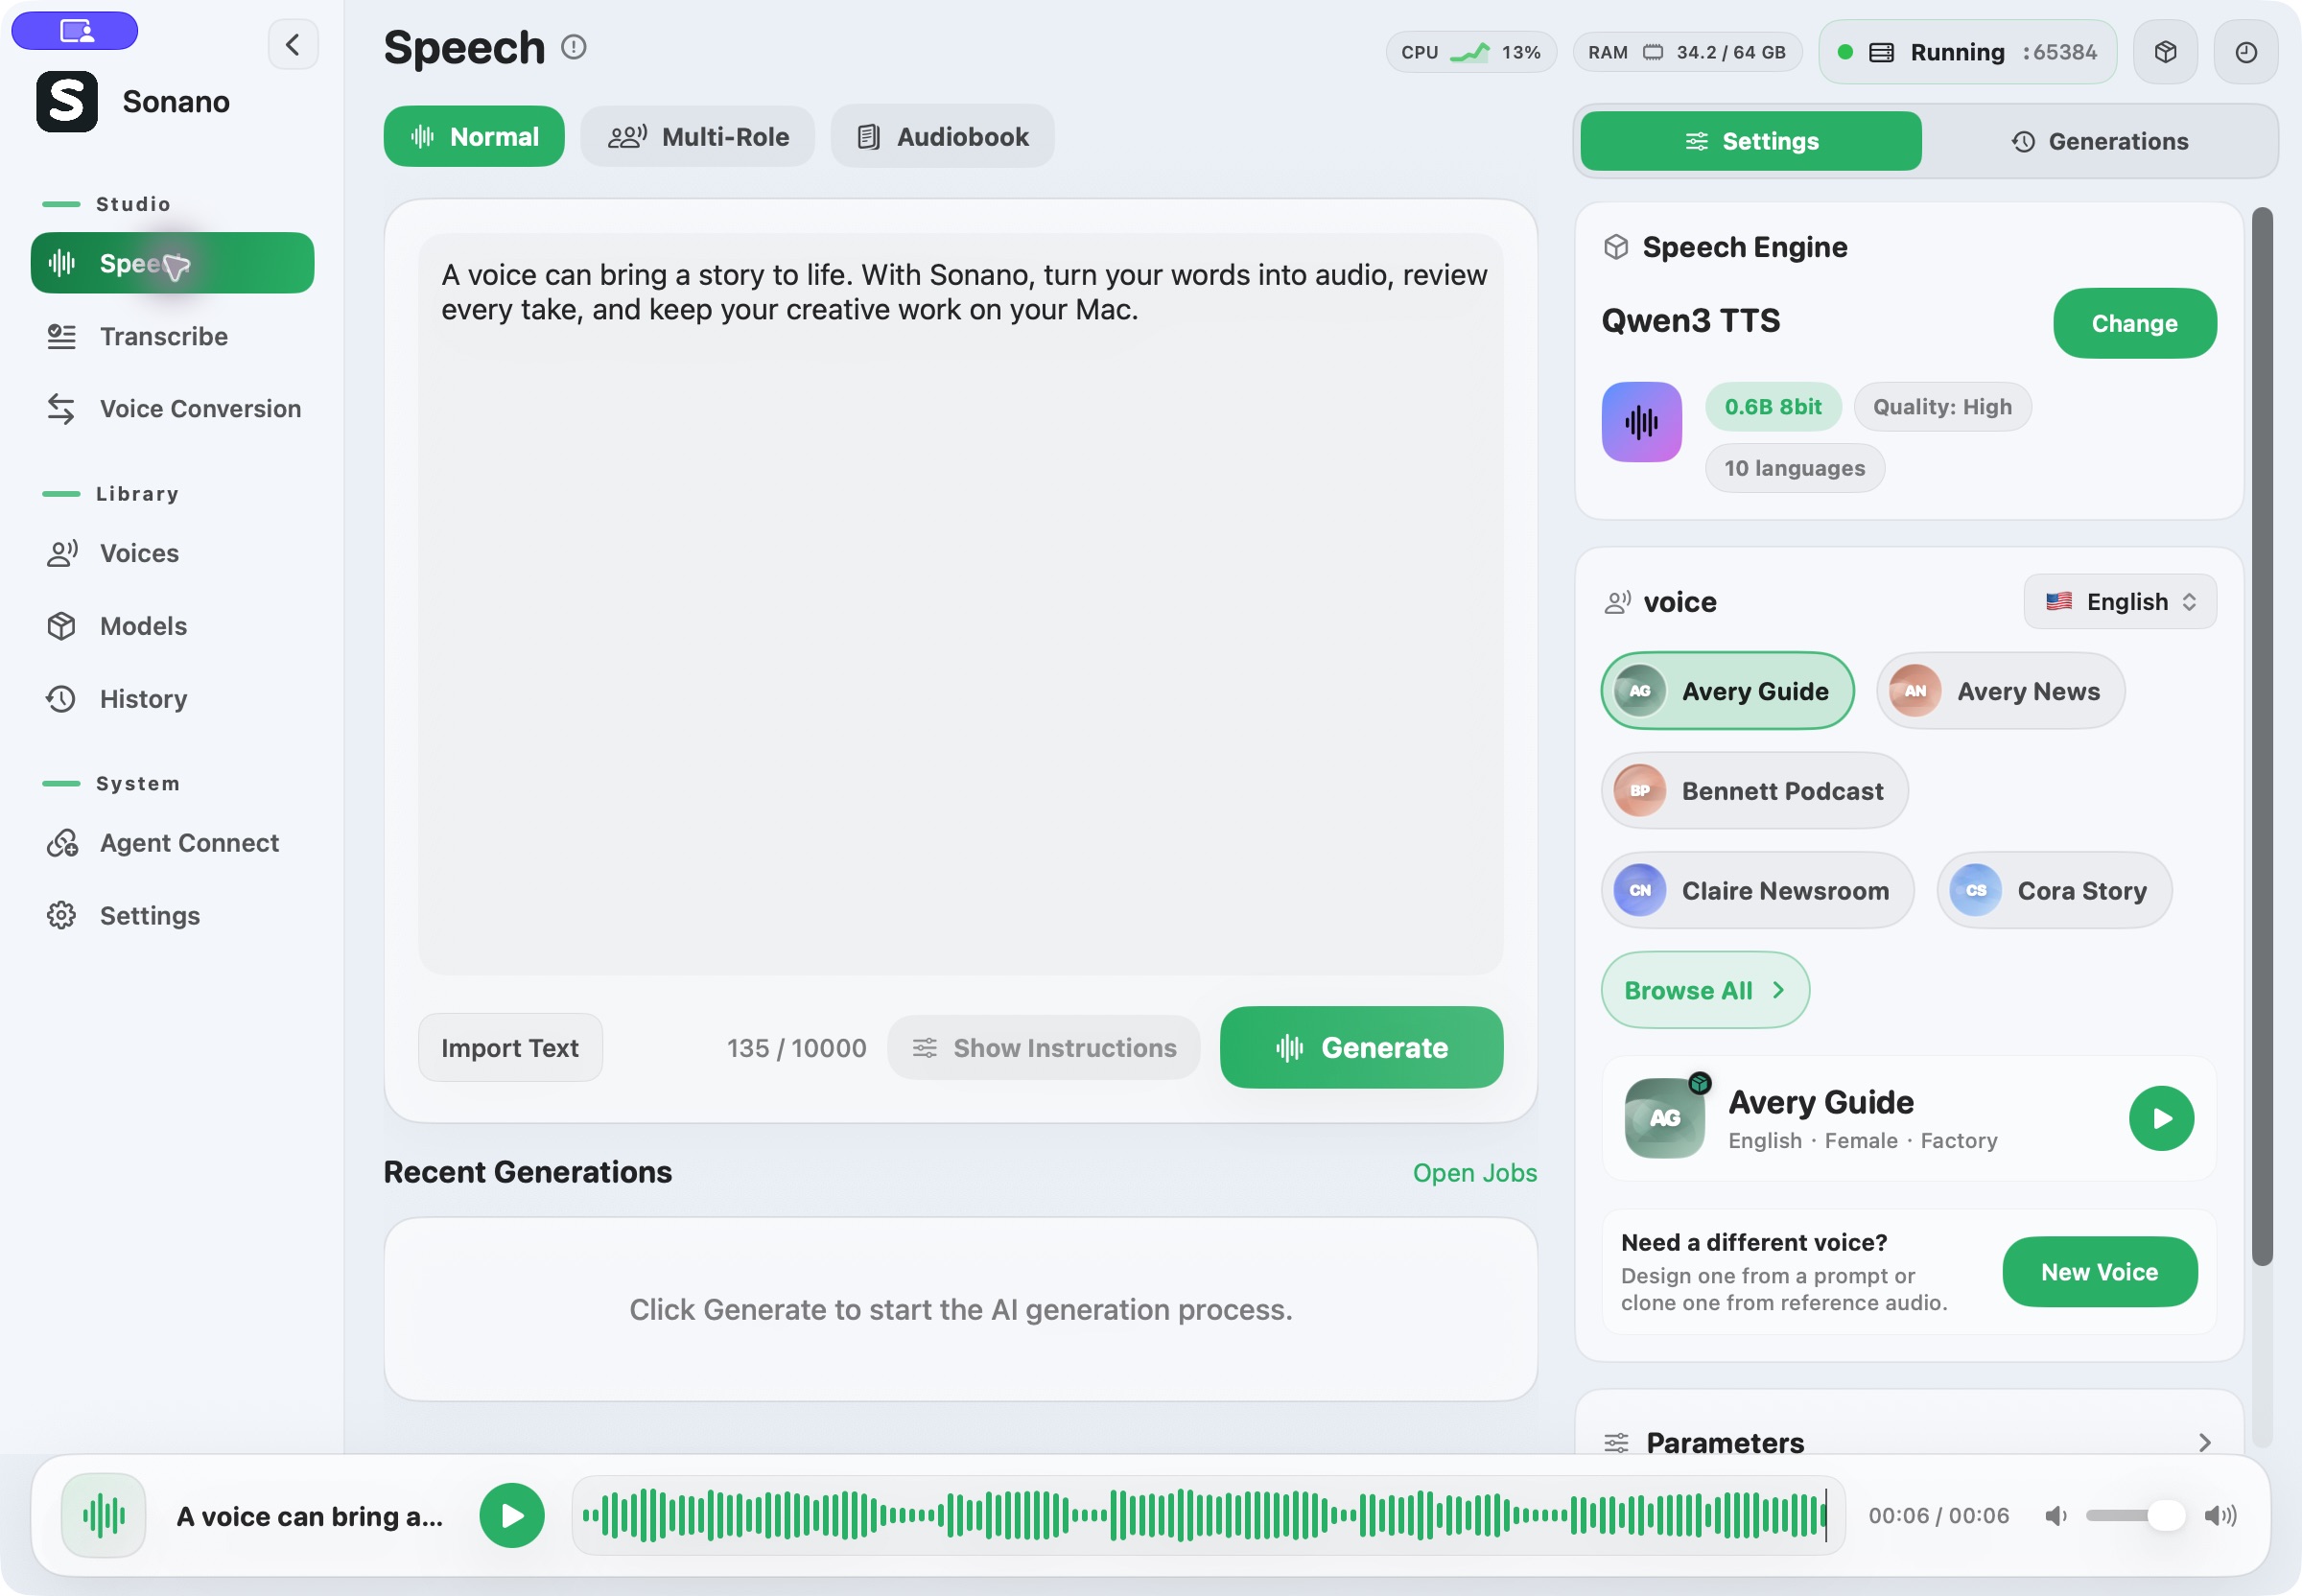
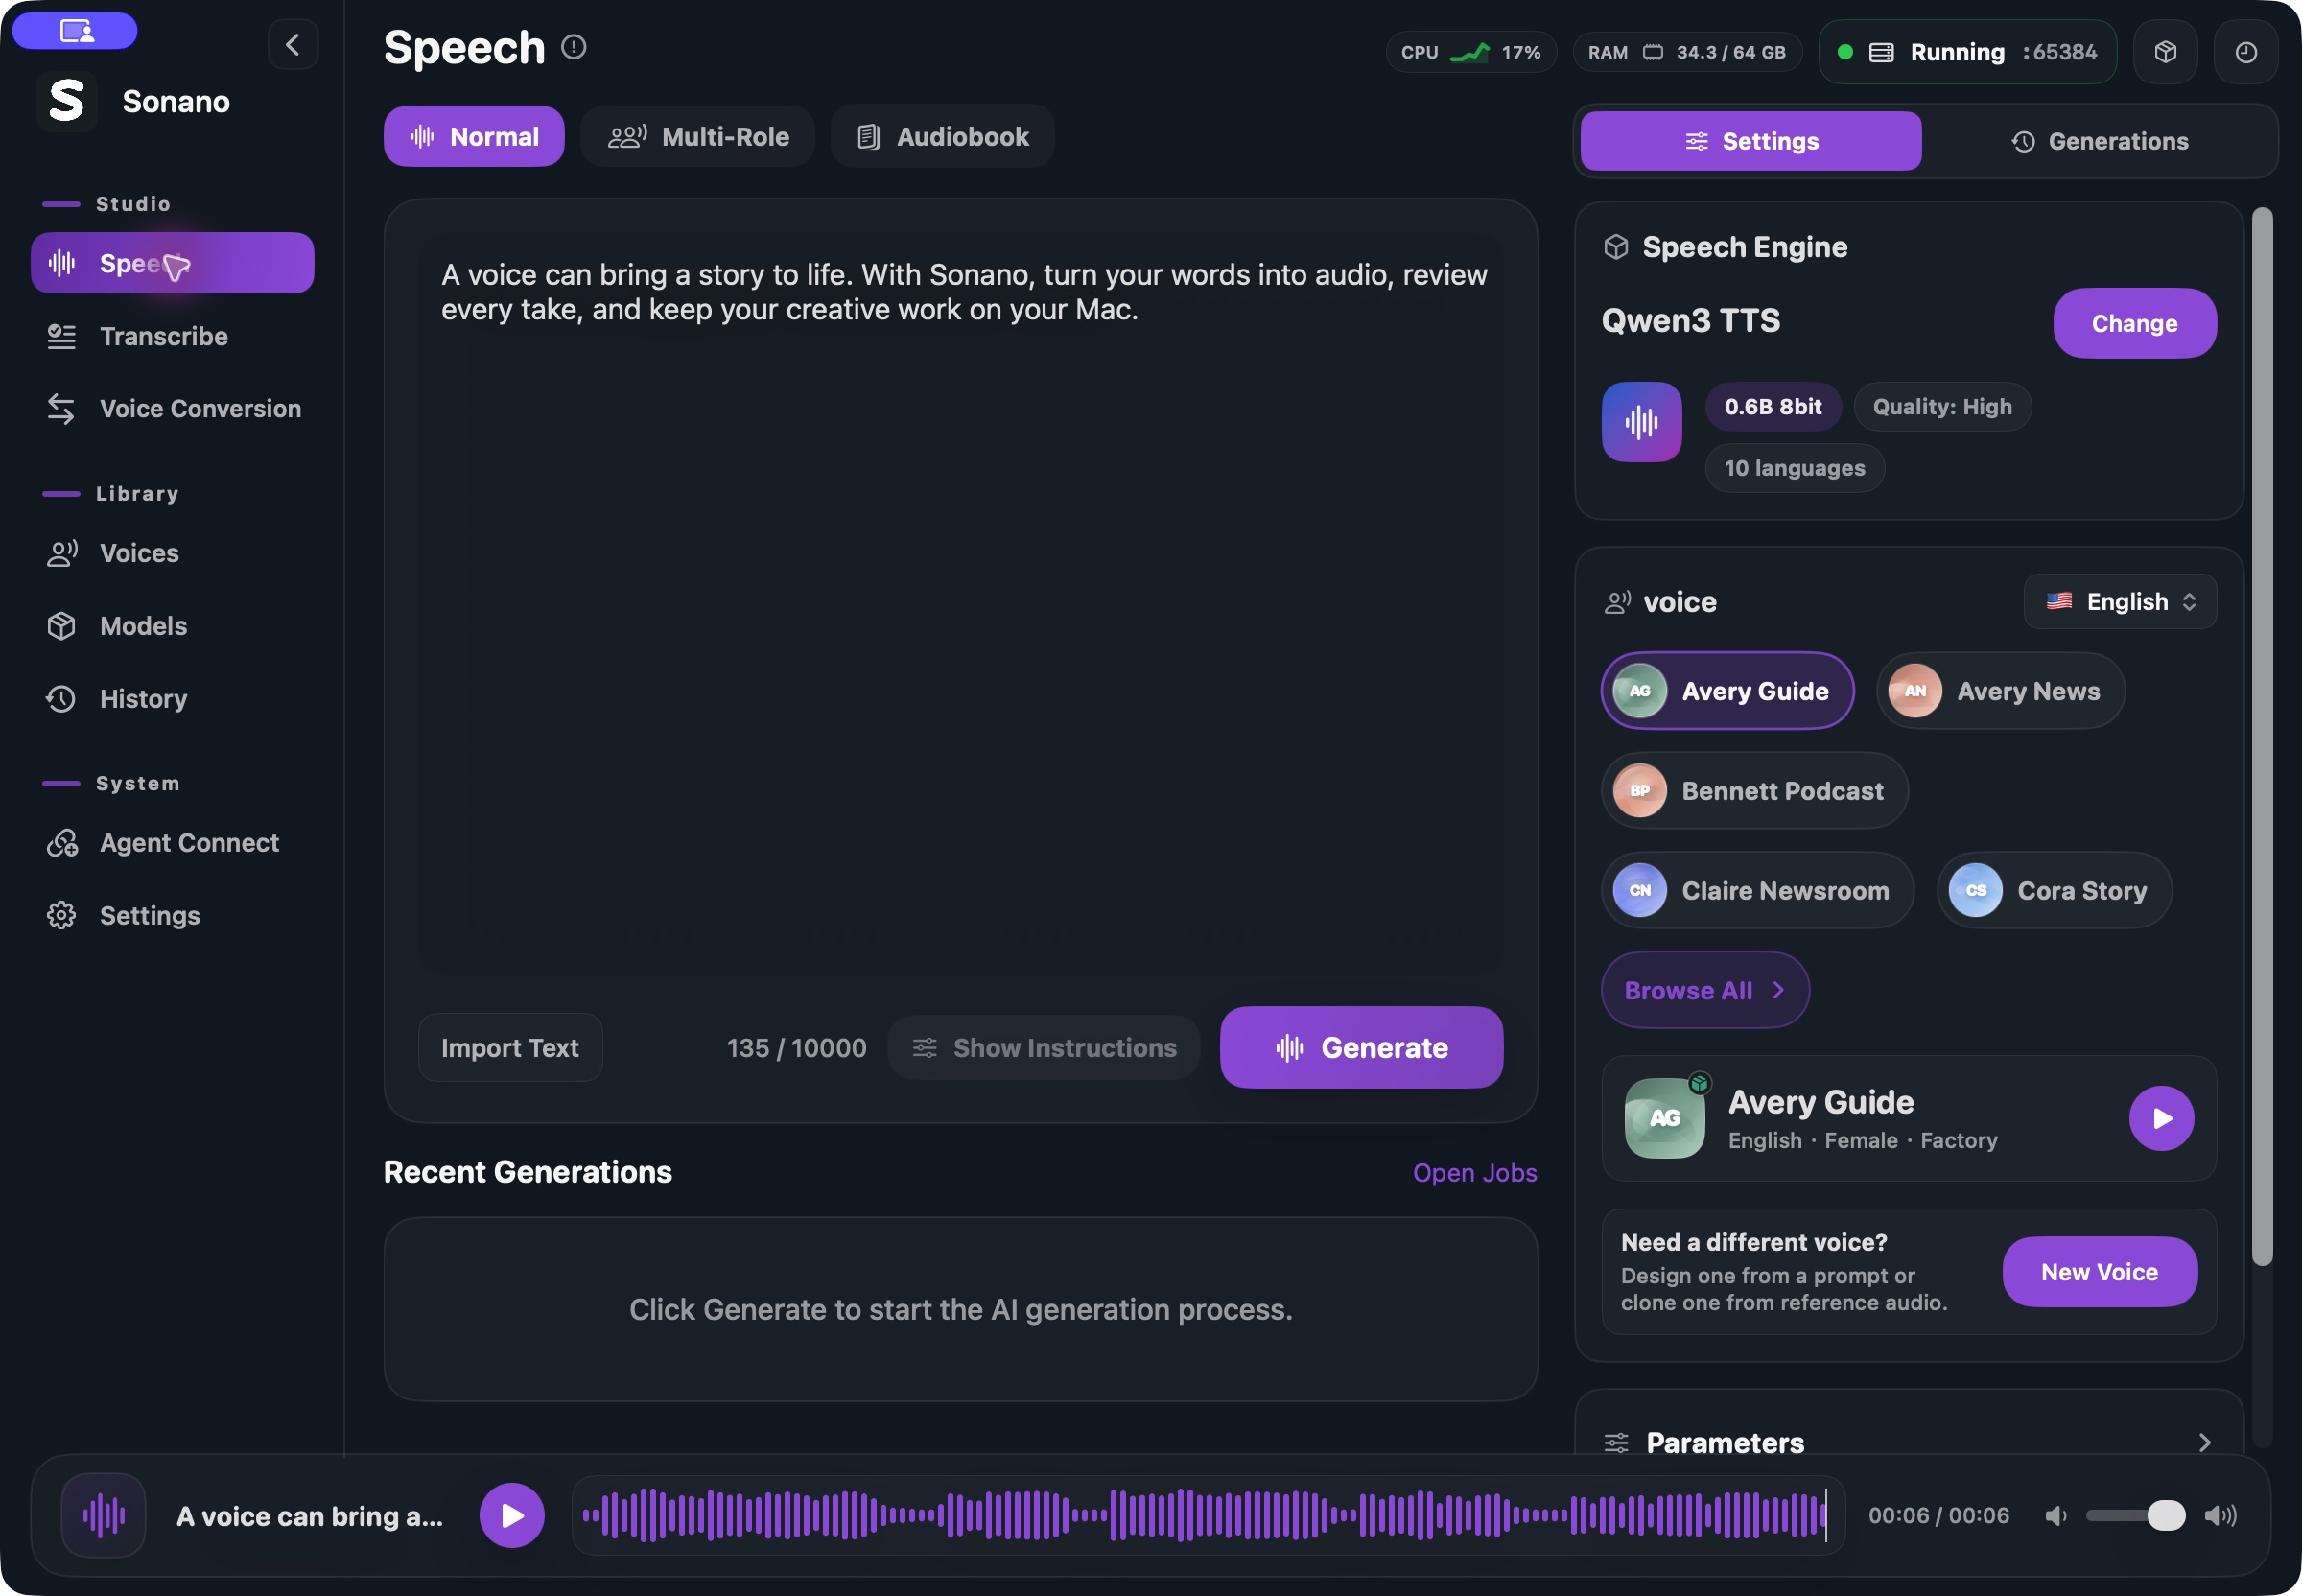
Sonano 不是只提供一套固定深色界面。用户可以在深色和浅色模式之间切换,并选择珊瑚、海洋、森林、暮光、琥珀、玫瑰金六种主色,让长时间编辑、录音审查和演示场景都更舒服。
界面语言
设置里的语言选择会立即生效,用户可以按系统语言或自己的使用习惯切换界面。模型名、文件路径和用户内容保持原文,App 导航与系统文案按当前界面语言显示。
主工作流
这些不是互不相干的页面。语音生成已经覆盖普通朗读、多角色脚本和有声书长文项目;转写结果可以导出字幕,声音库里的声音可以继续用于生成和转换,所有长任务都能被追踪。
普通朗读、多角色脚本和有声书项目都在 Speech Studio 中完成。主路径始终围绕“模型 -> 输出语言 -> 声音”,生成结果进入同一套播放器、历史、导出和产物系统。

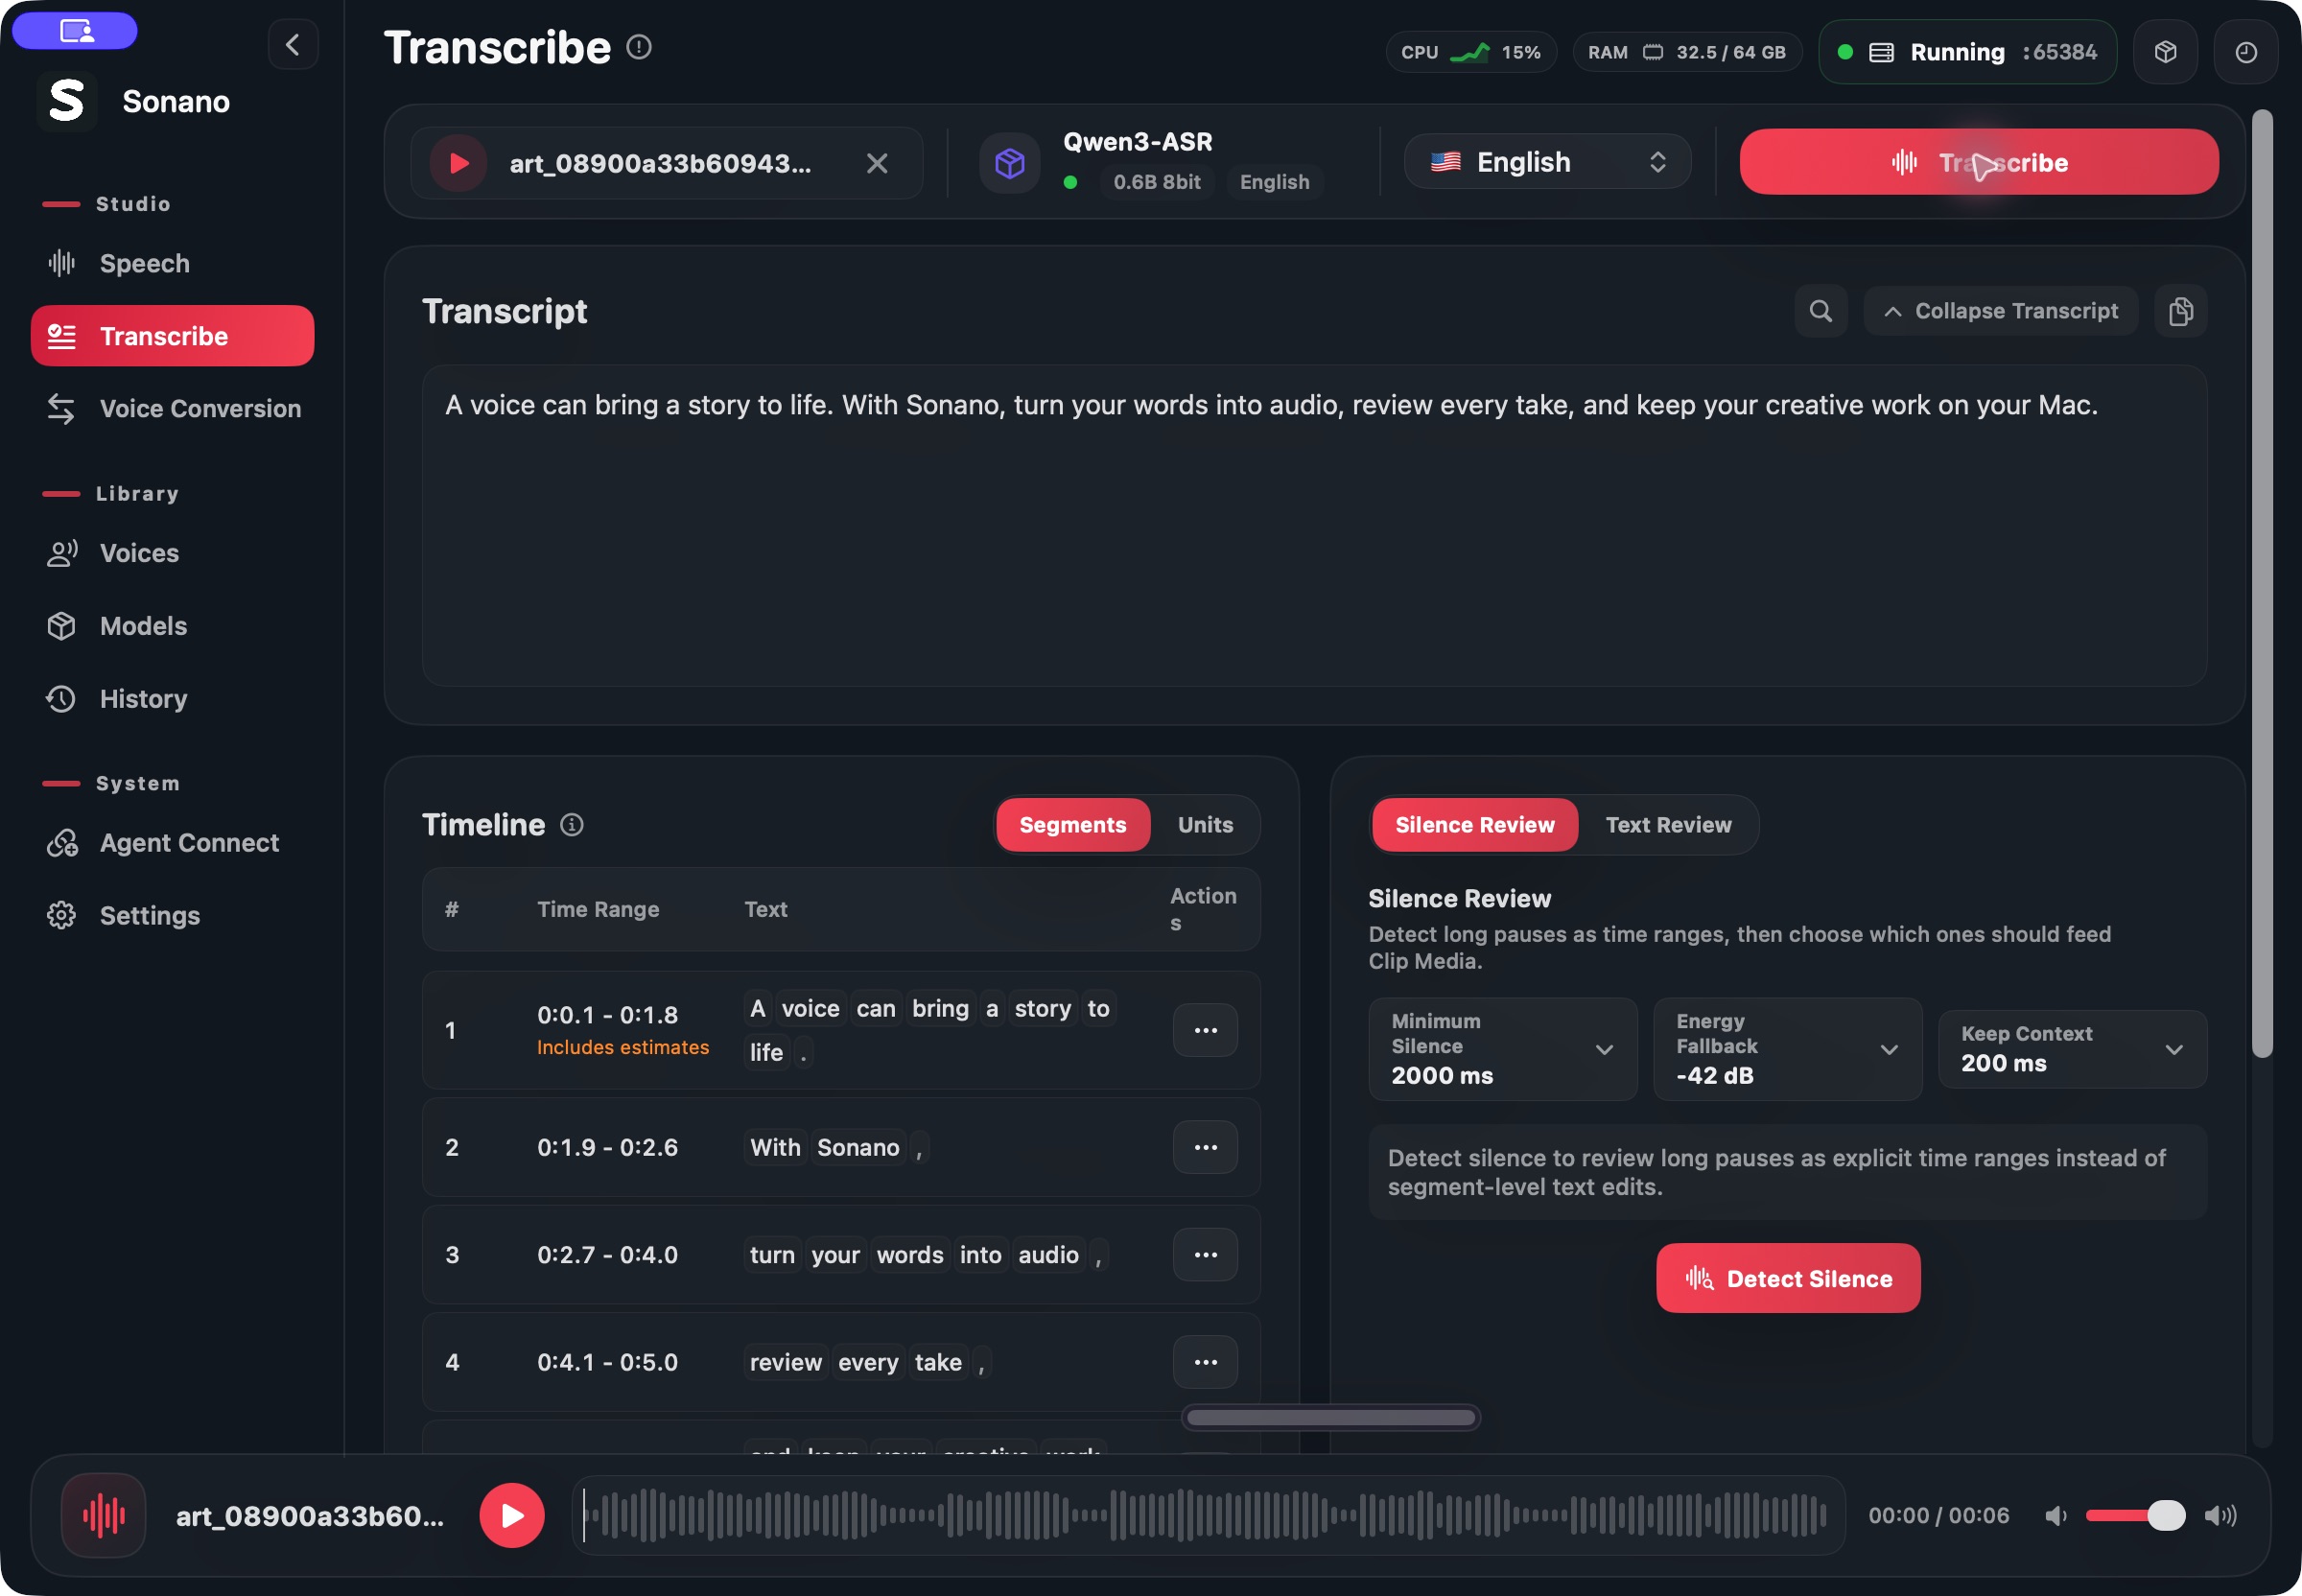
导入音频或视频,在本机生成转写文本、时间线和字幕。静音审查与文本审查分开处理,适合口播、课程、播客和视频素材。

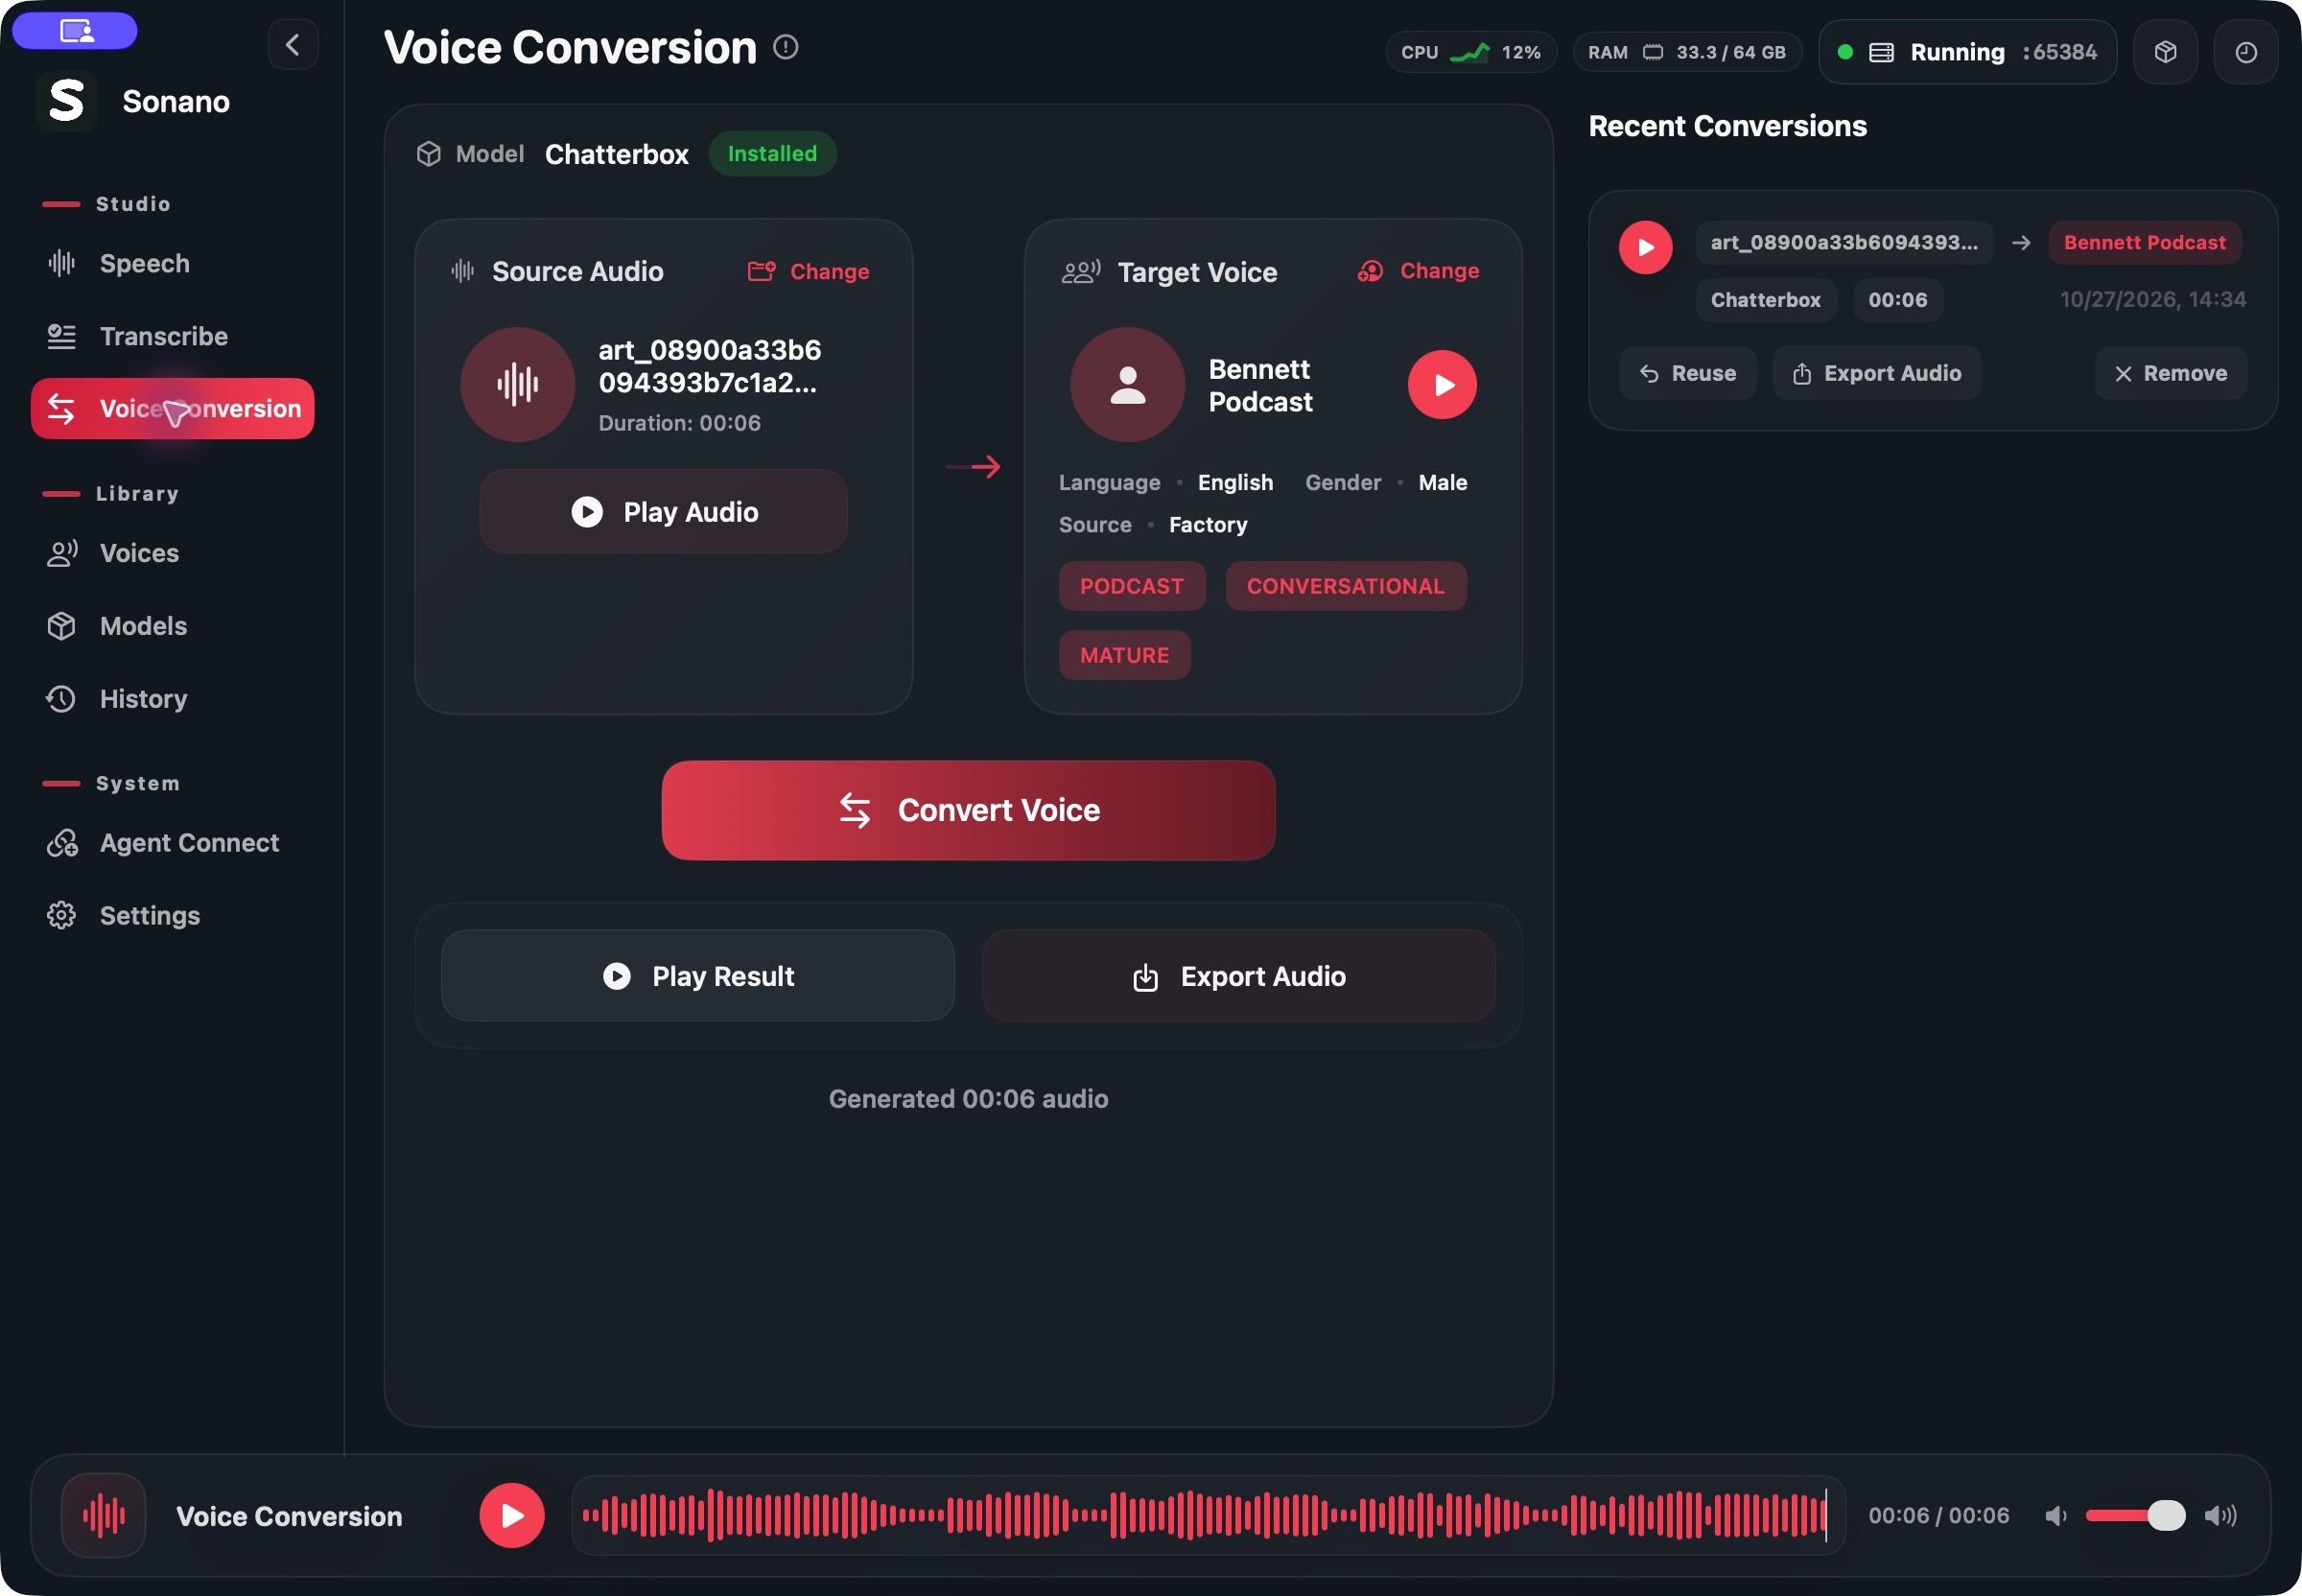
导入源音频,选择声音库中的受管目标声音,转换结果可播放、复用、导出,也会进入最近转换和历史。
创建声音
除了内置声音,Sonano 可以从文字描述生成短样本,也可以用参考录音和脚本克隆声音;确认后的结果会沉淀为可复用声音资产,继续用于语音生成、有声书、多角色脚本和 Agent 调用。
选择如何创建声音
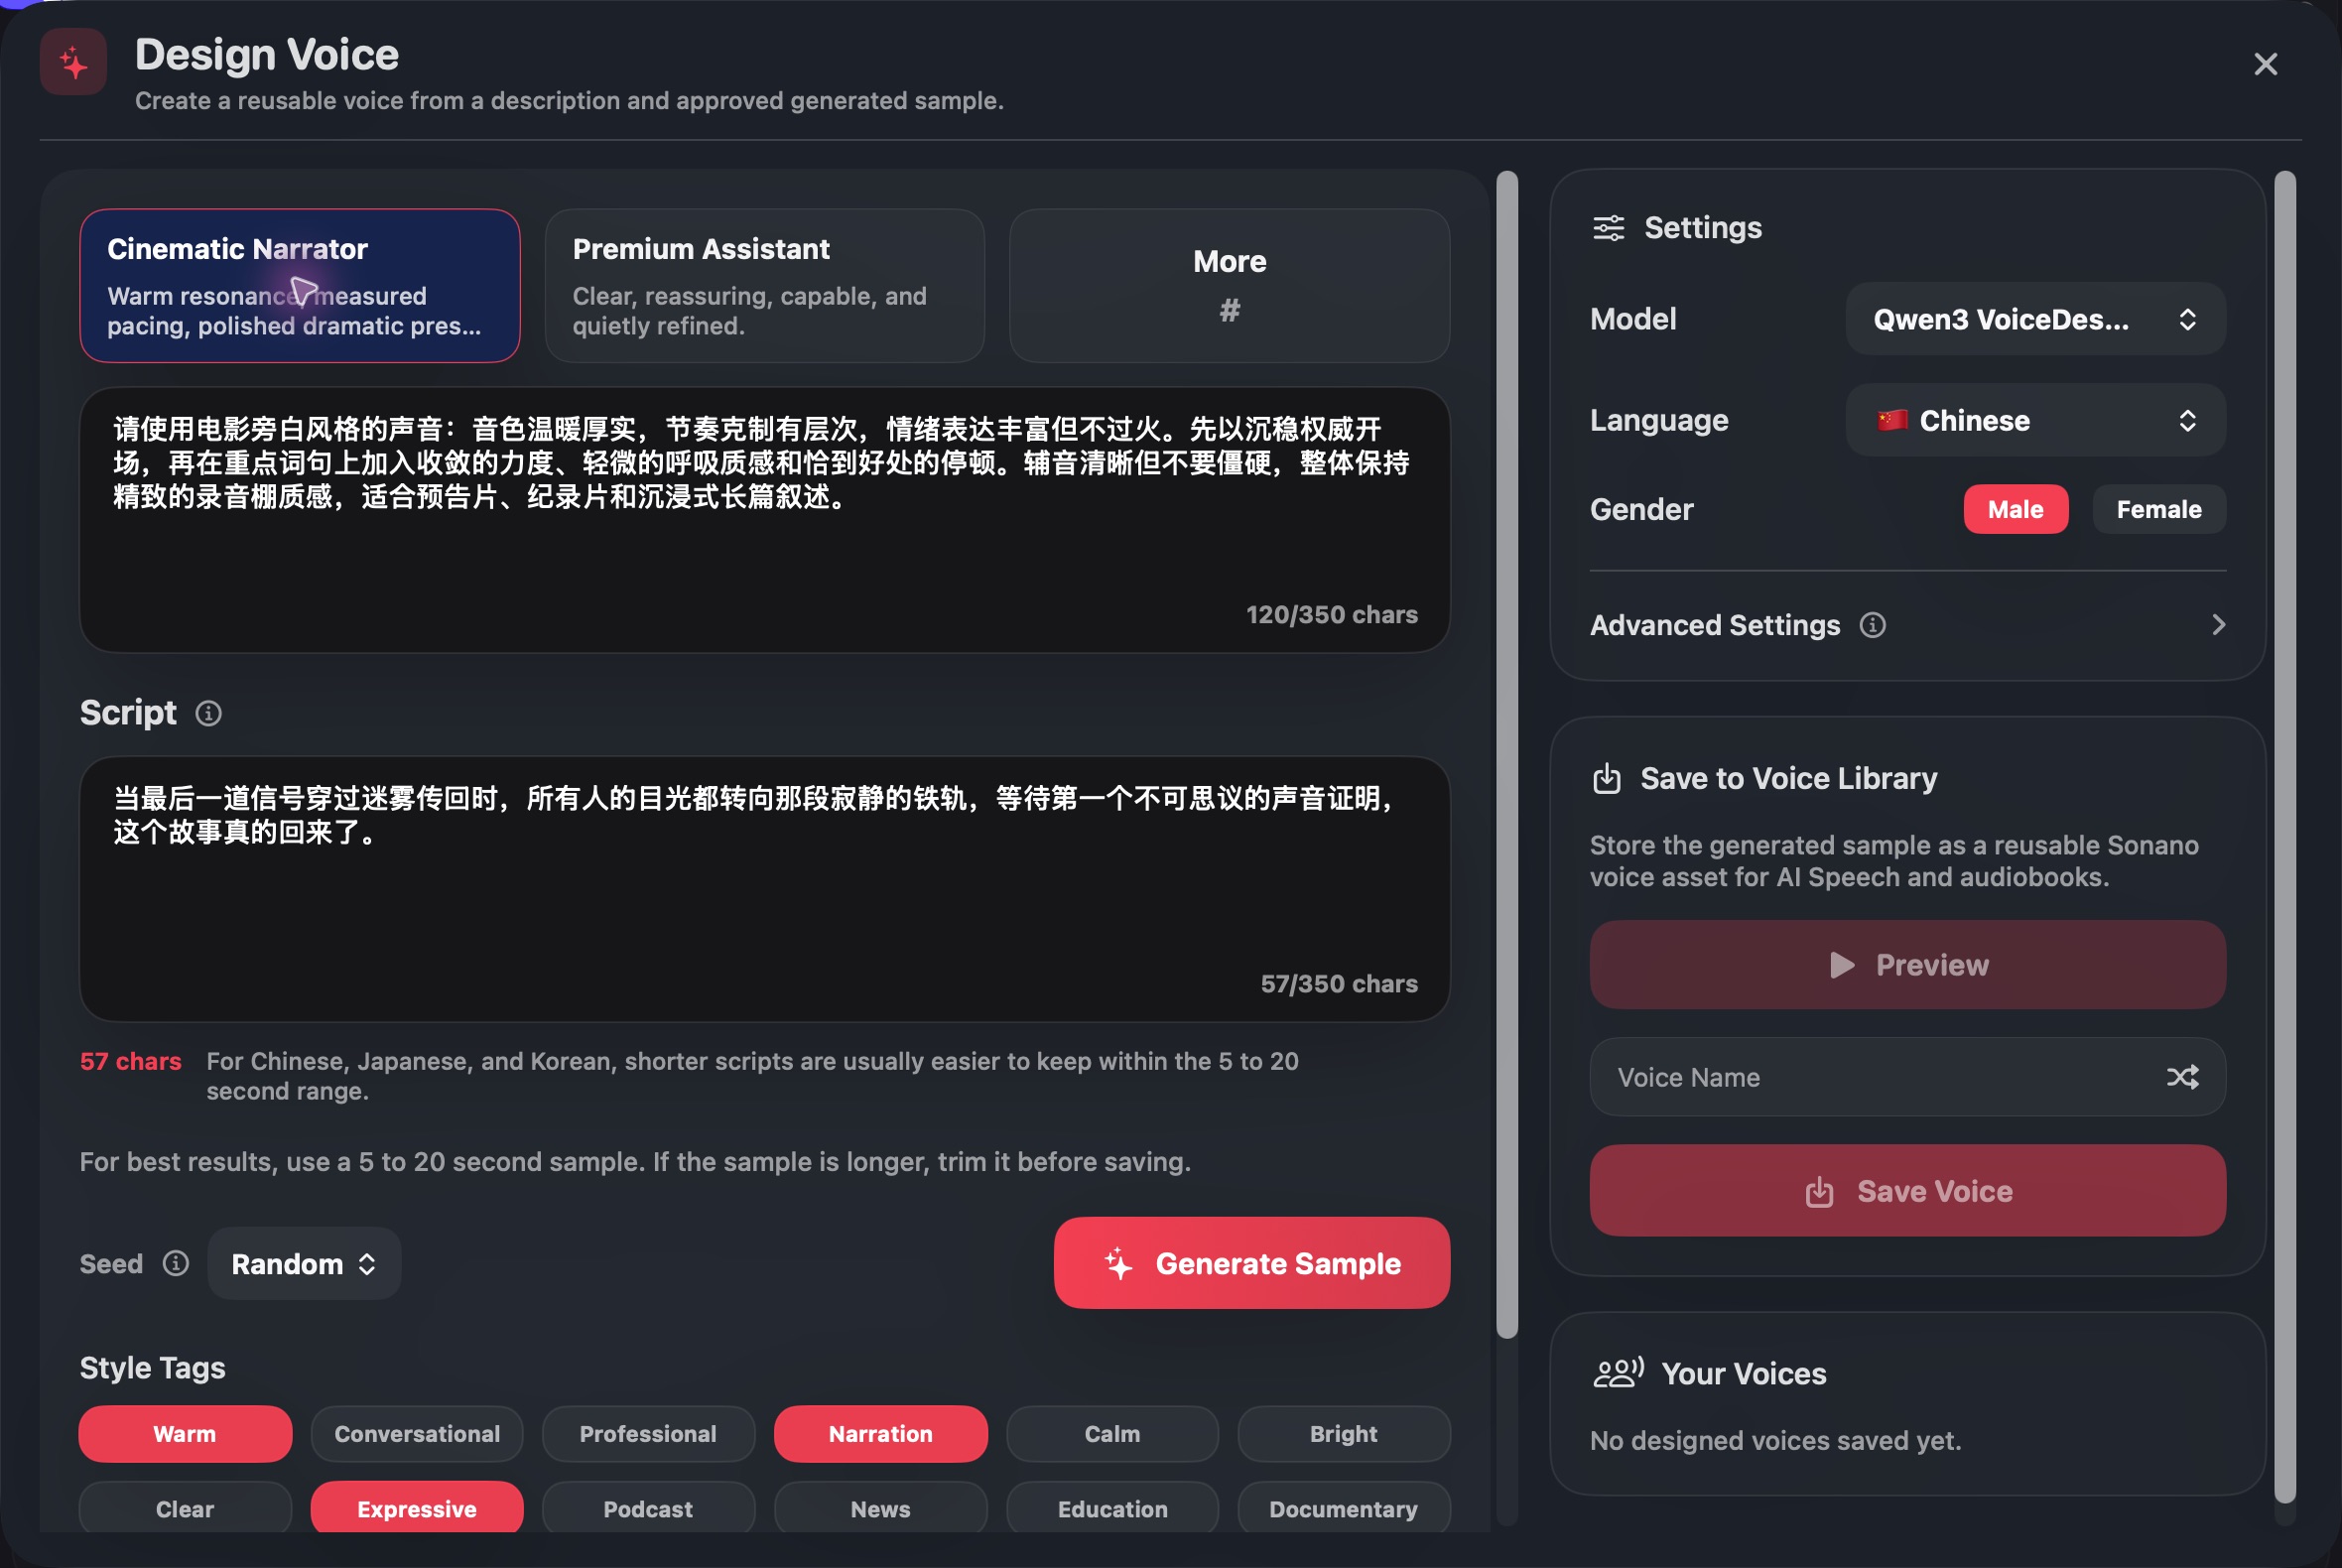
选择模型、语言和性别,输入风格描述与试读脚本,再用标签细化声音气质。生成样本满意后,一键保存为新的声音资产。
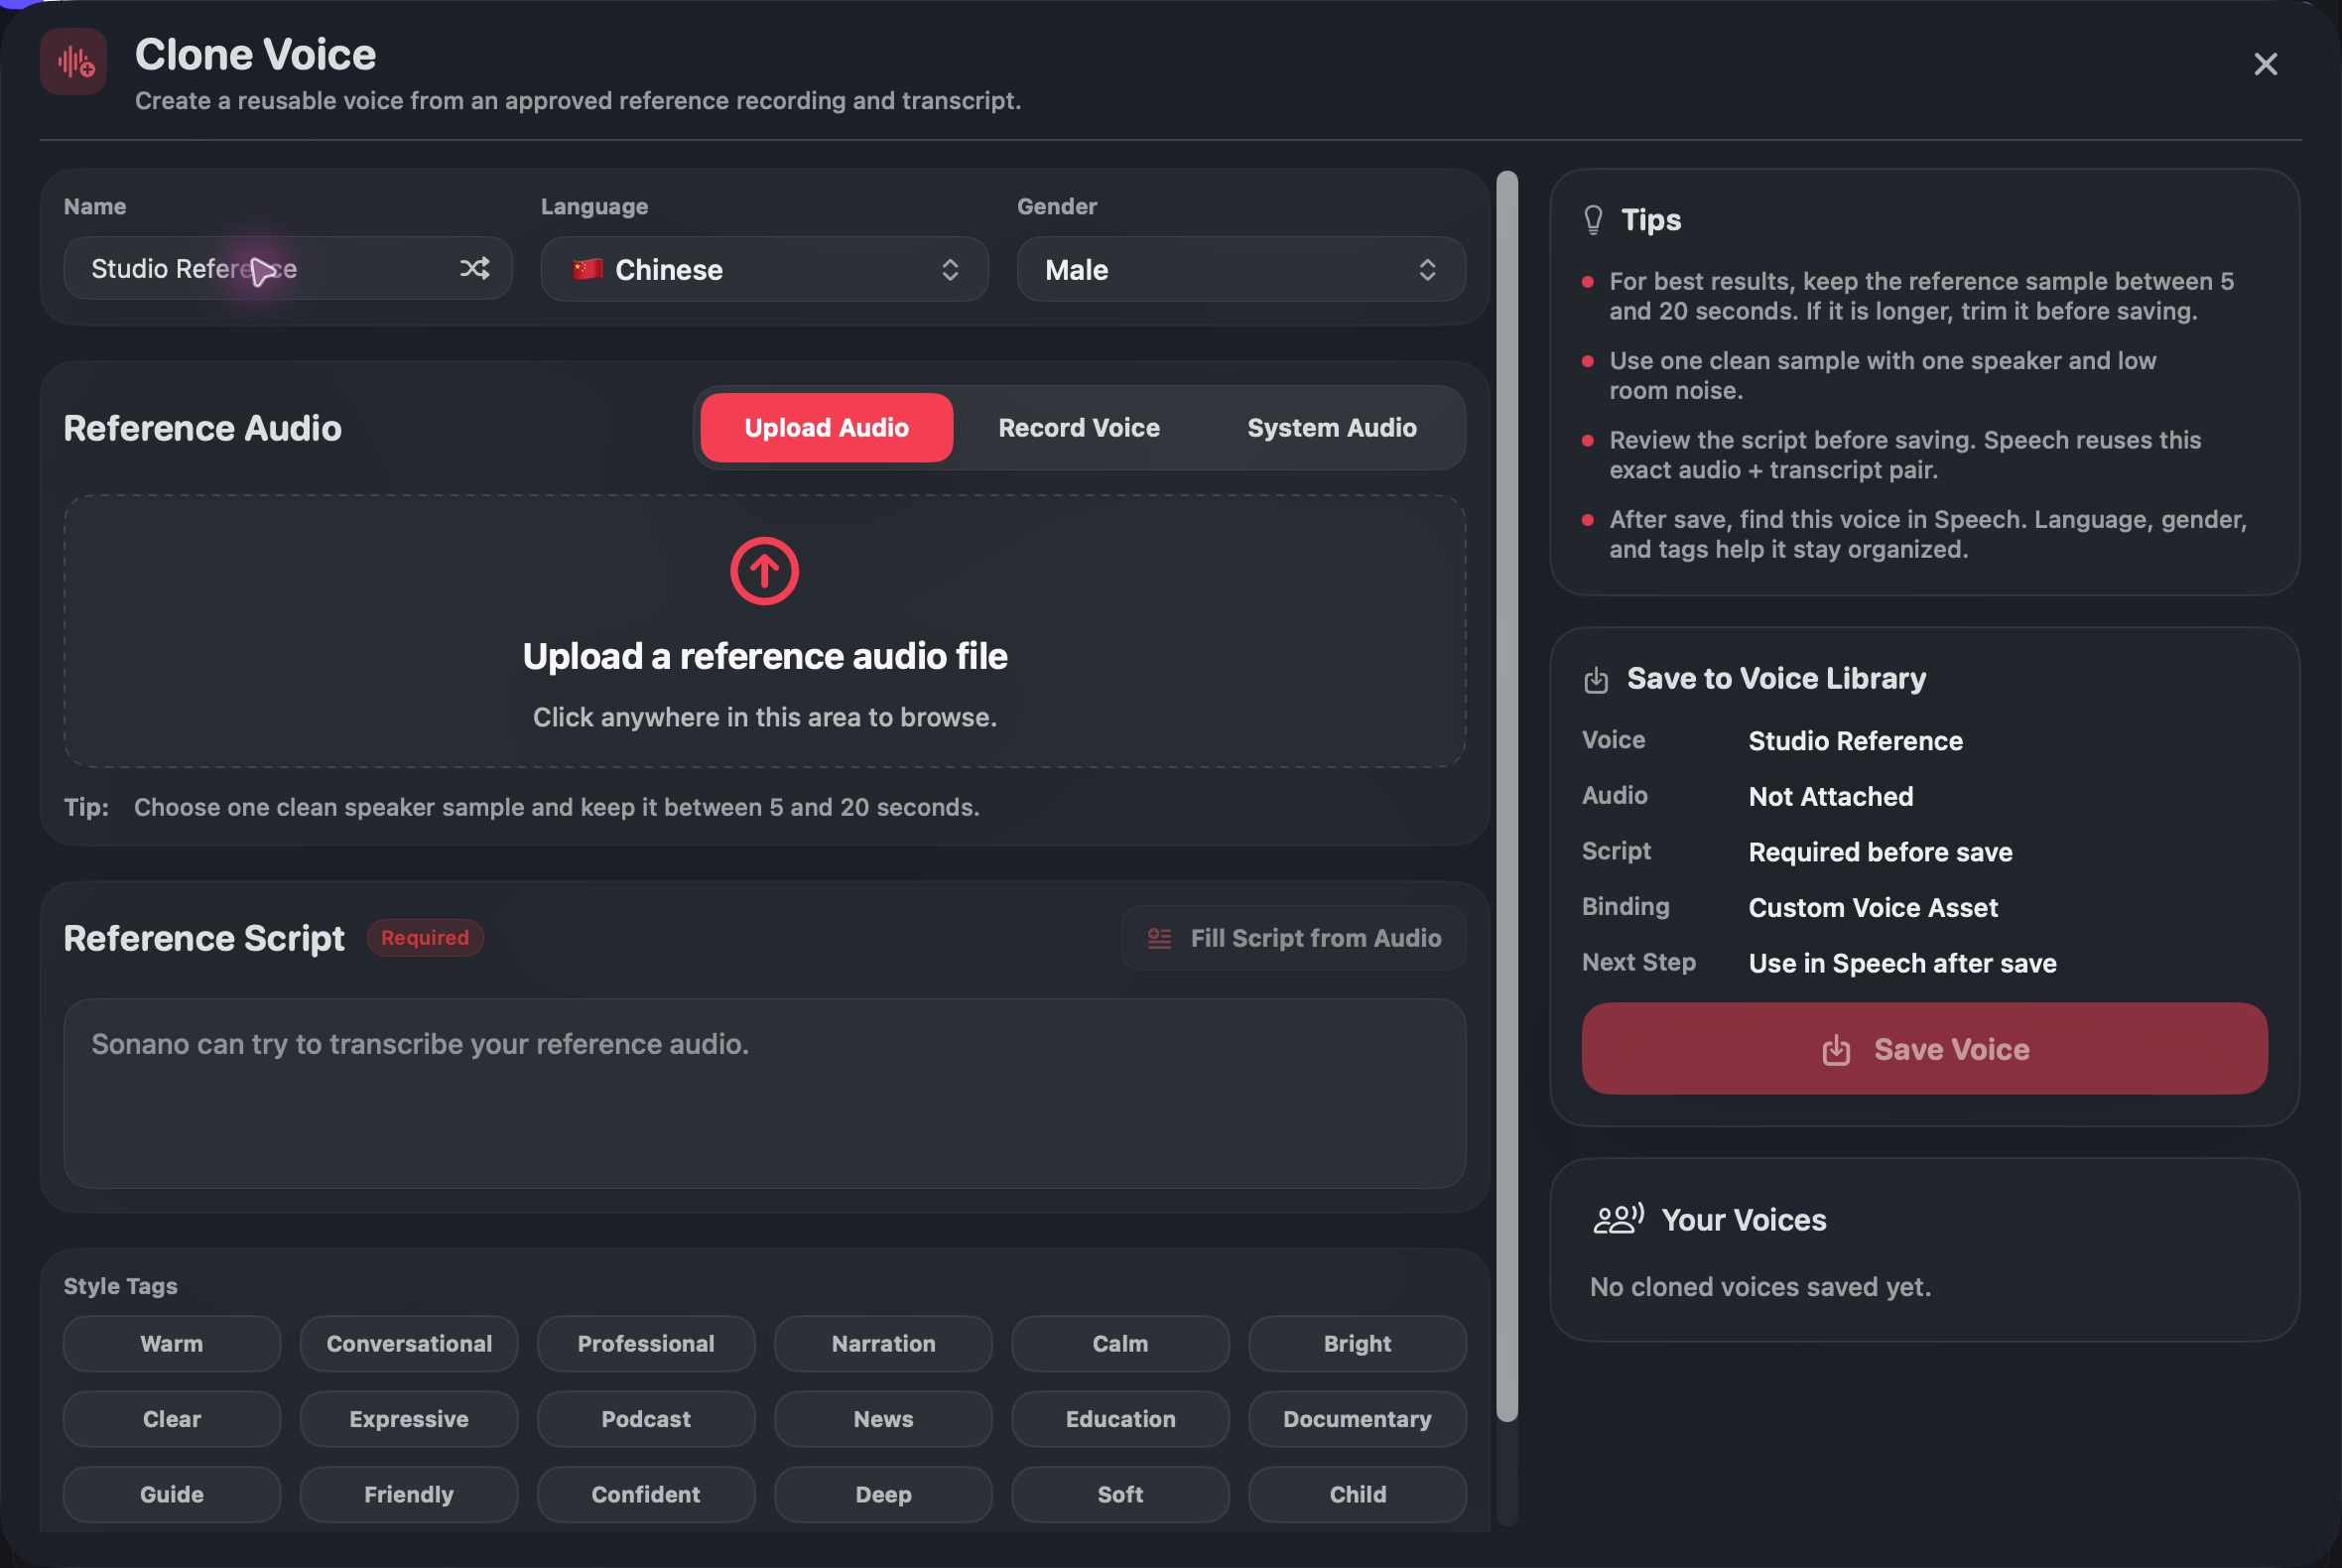
把干净的 5 到 20 秒说话人样本与参考脚本绑定,保留语言、性别和风格标签,生成后进入同一套声音库管理。
声音资产
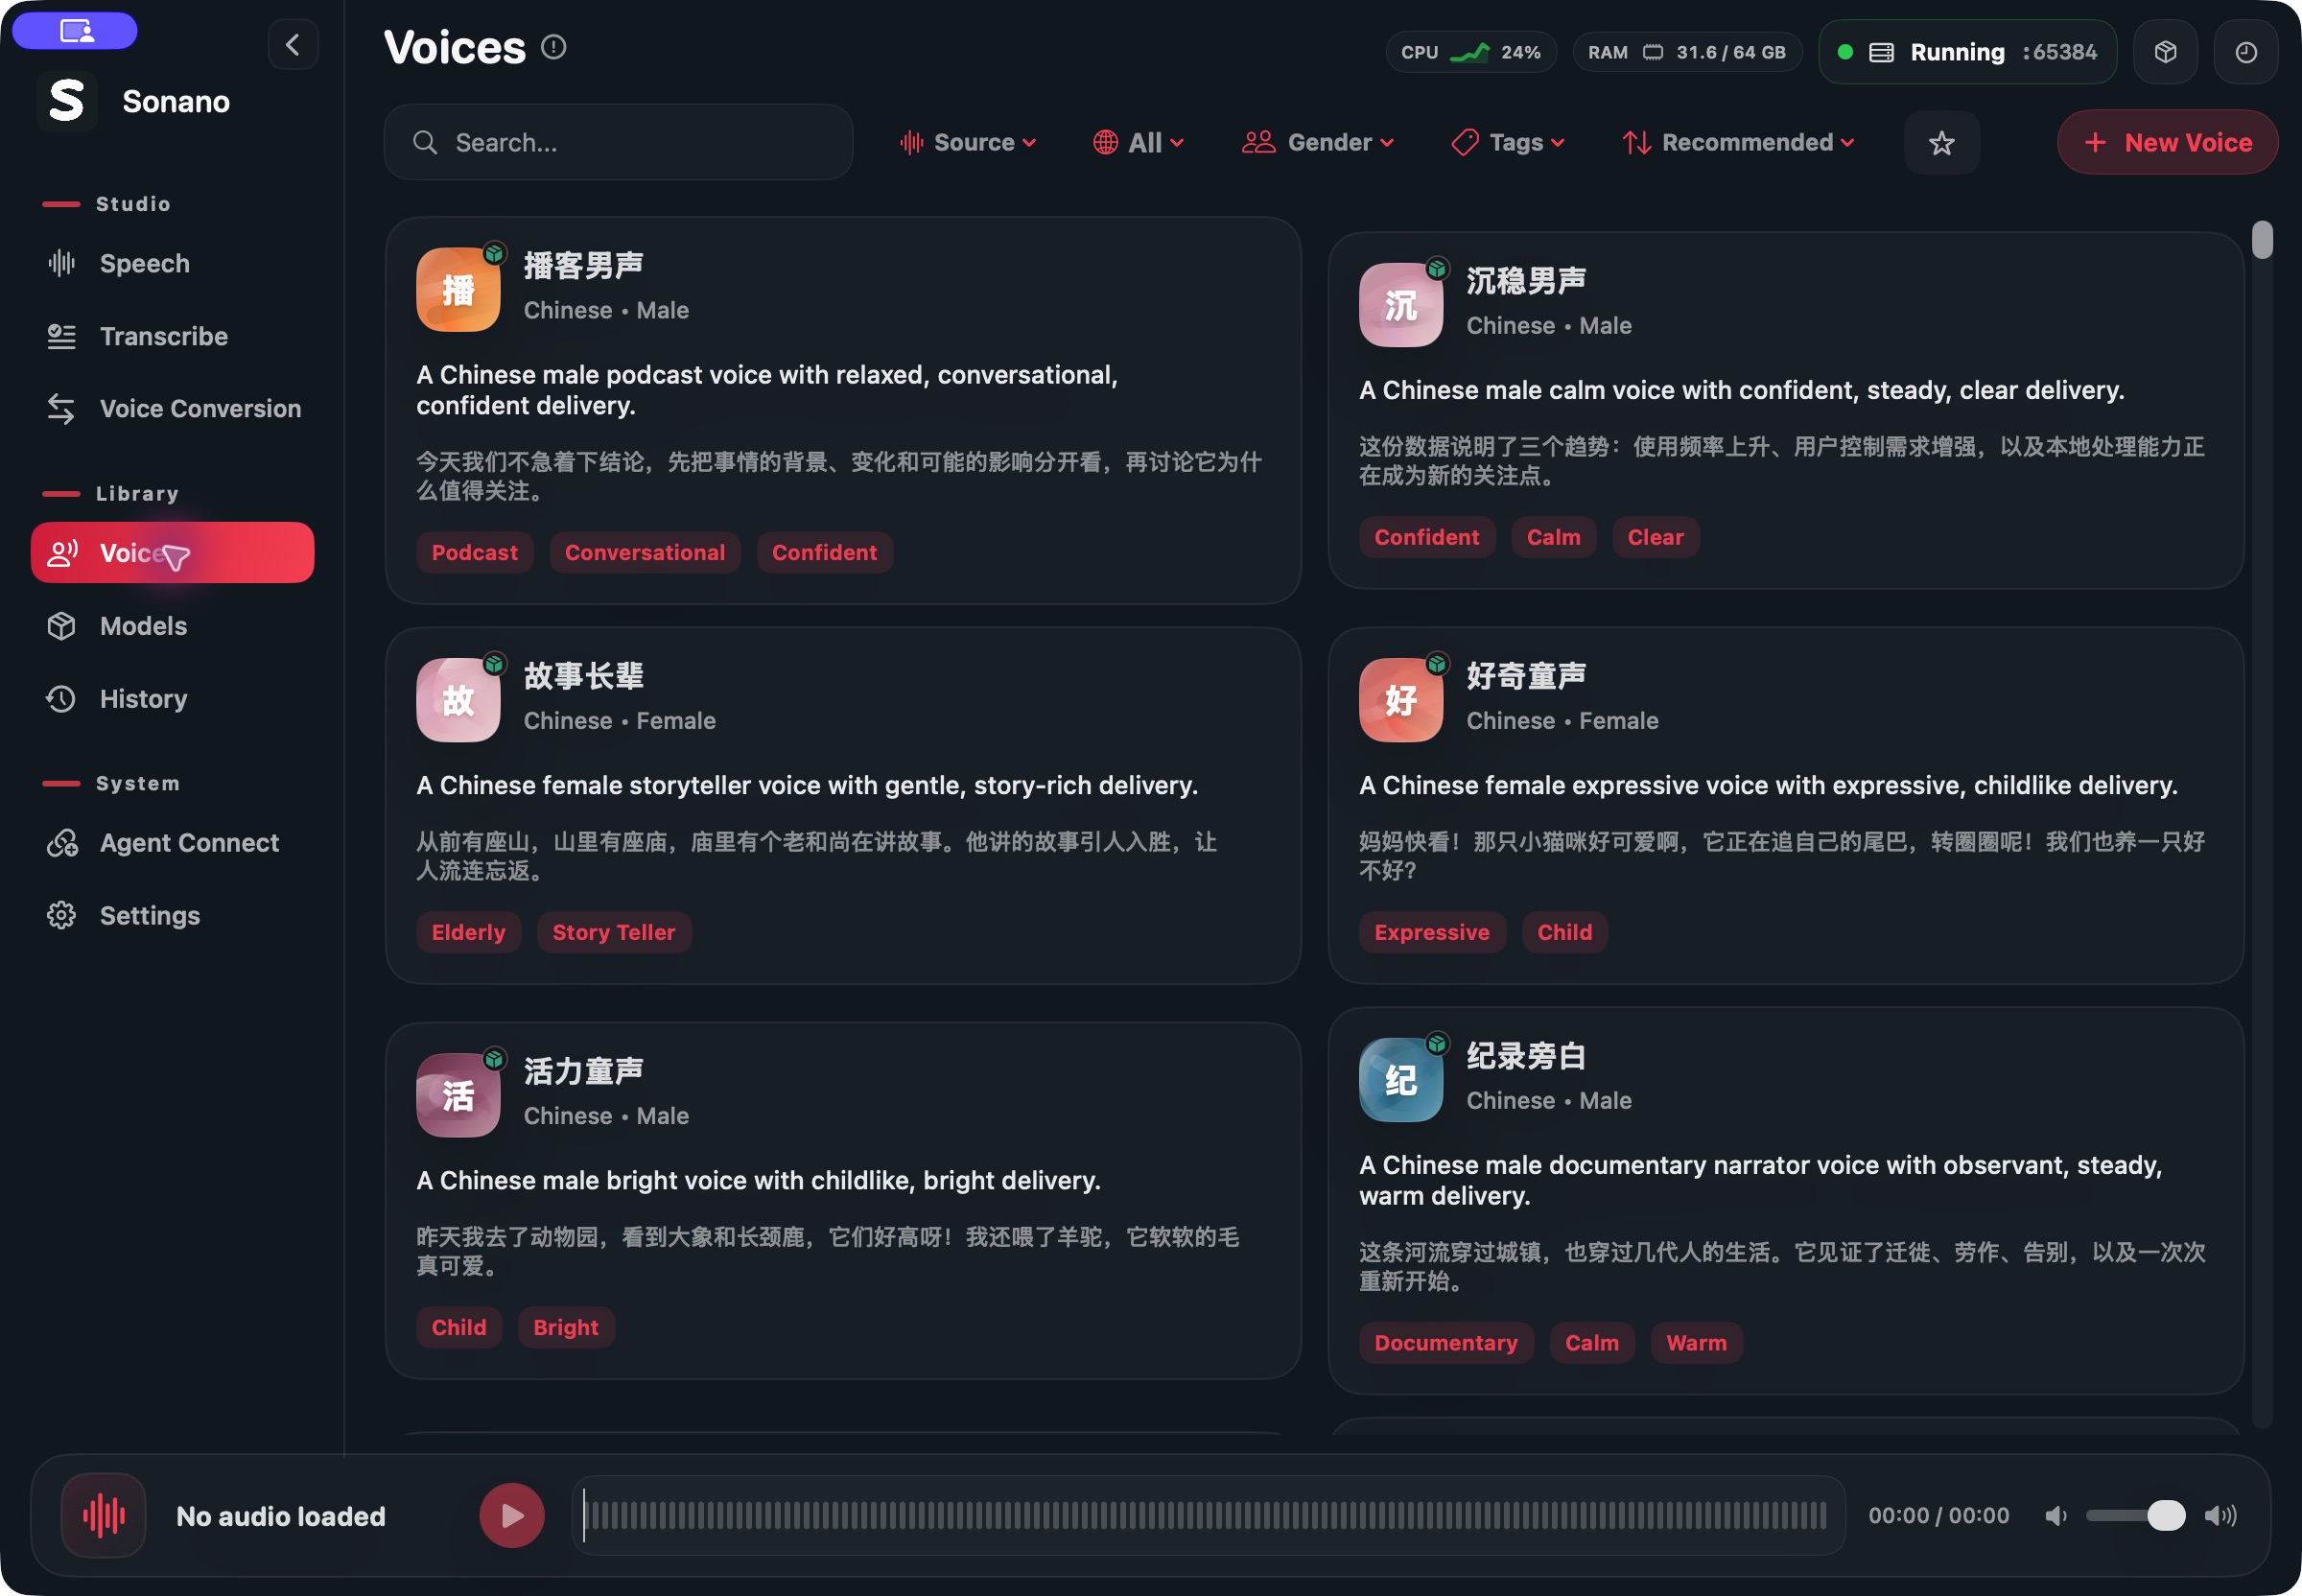
声音不是一次生成时的临时参数。Sonano 把预设声音、出厂声音、设计声音和克隆声音放进统一声音库,保留语言、来源、性别、标签、授权确认和参考样本。保存一次,之后可以在语音生成、声音转换和 Agent 调用里继续使用。
产品控制面
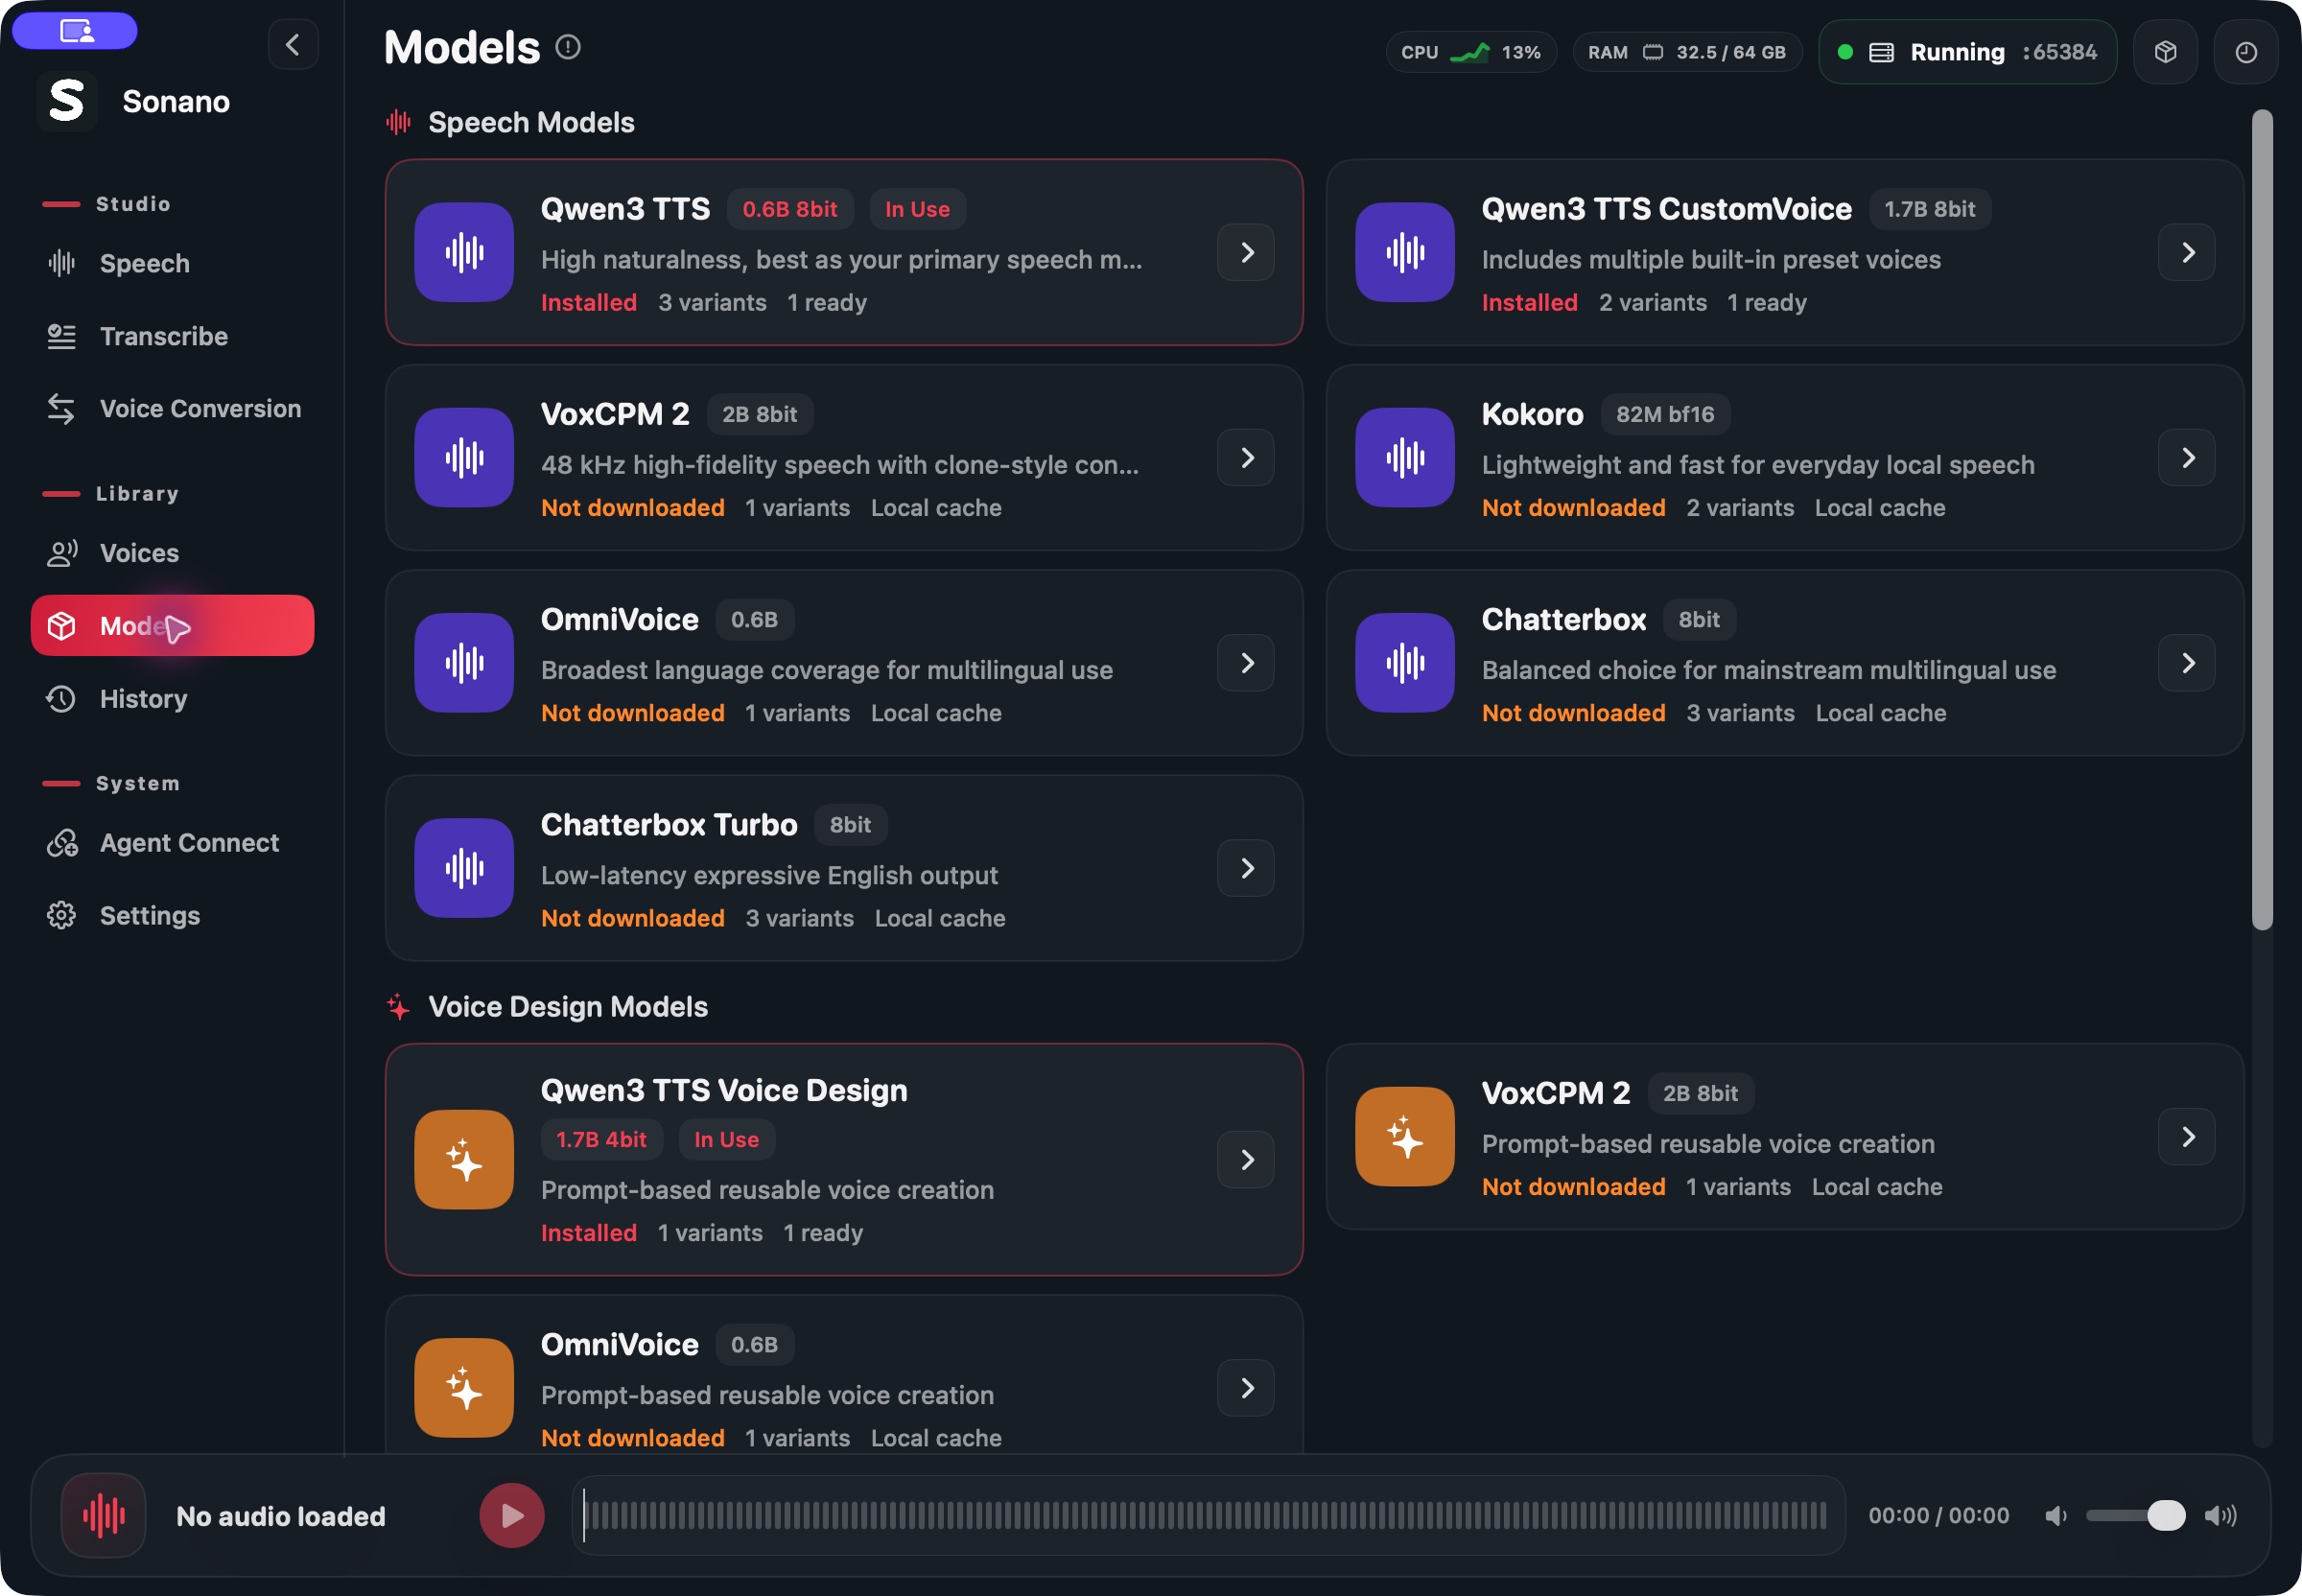
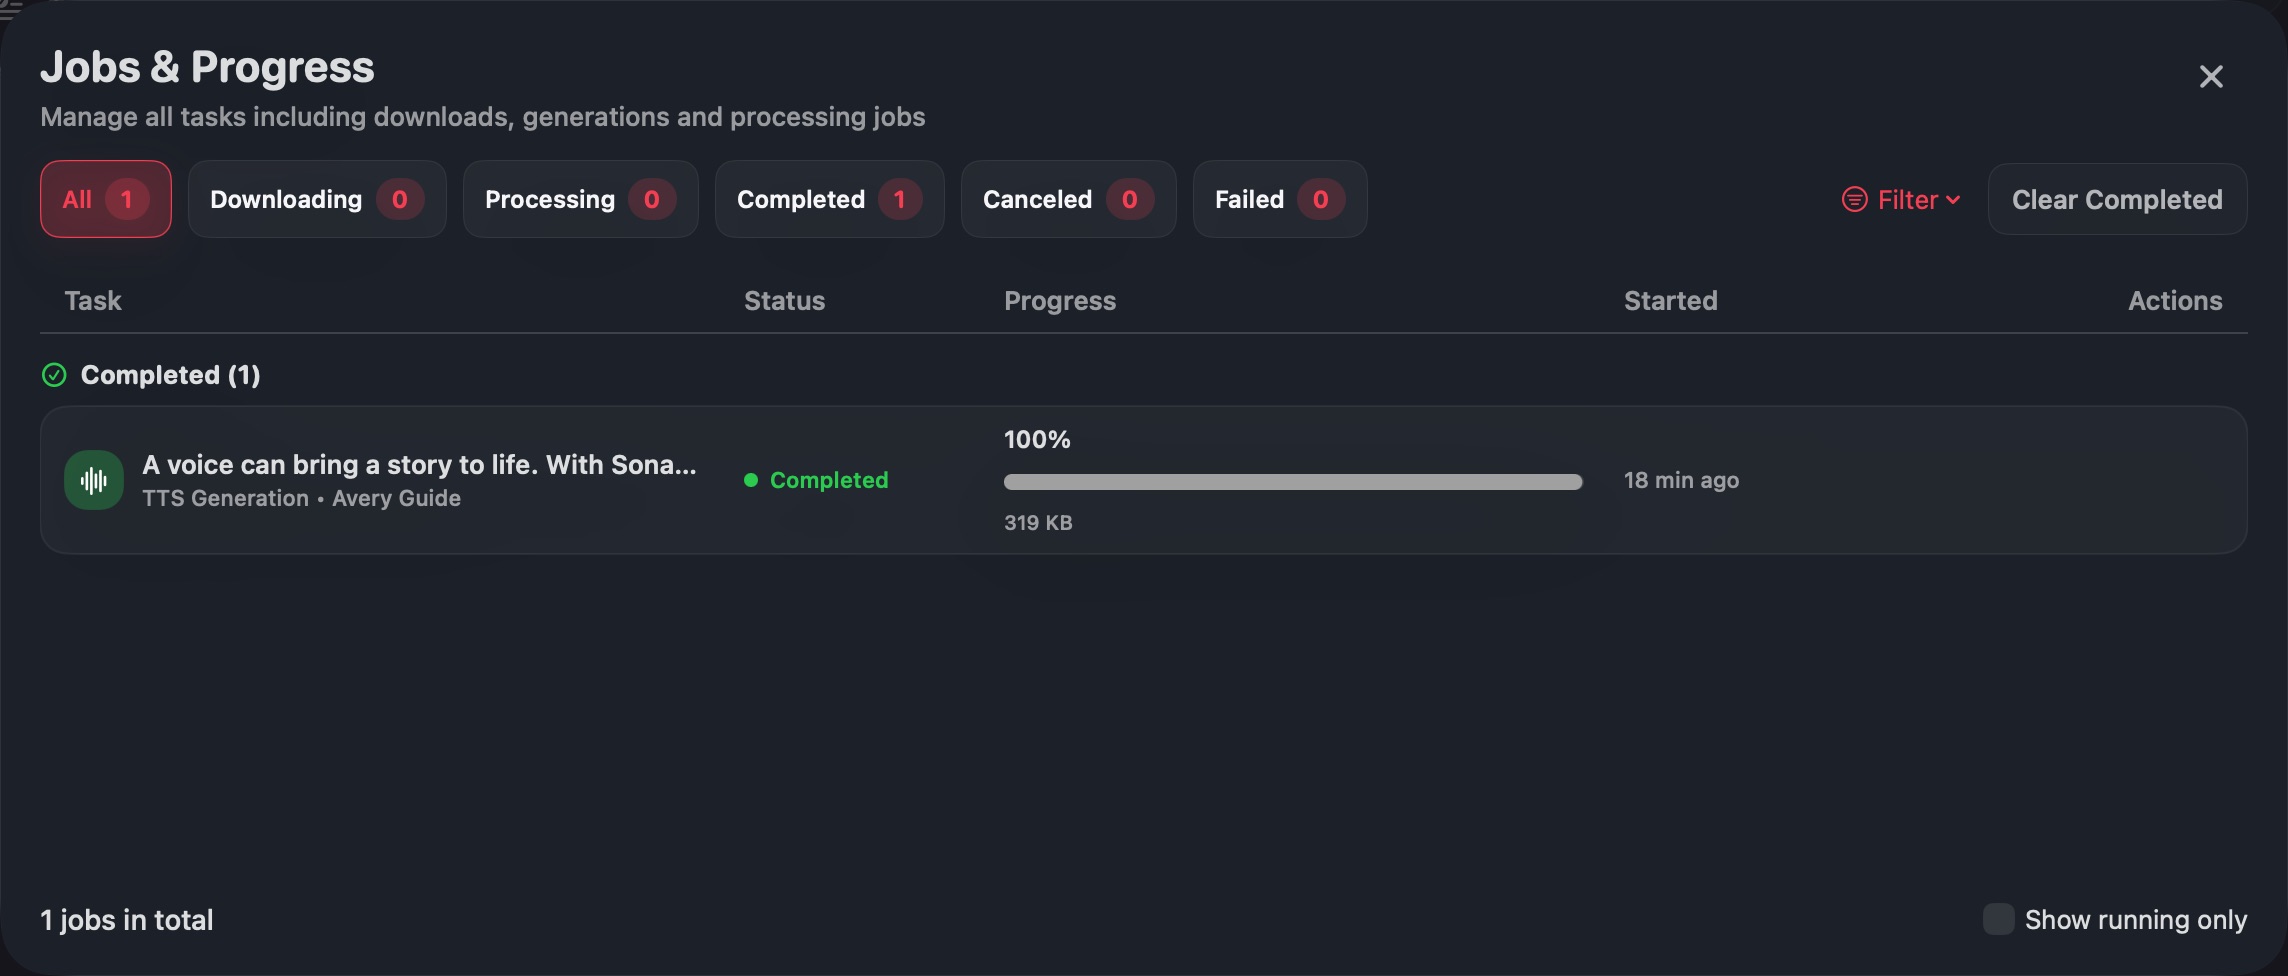
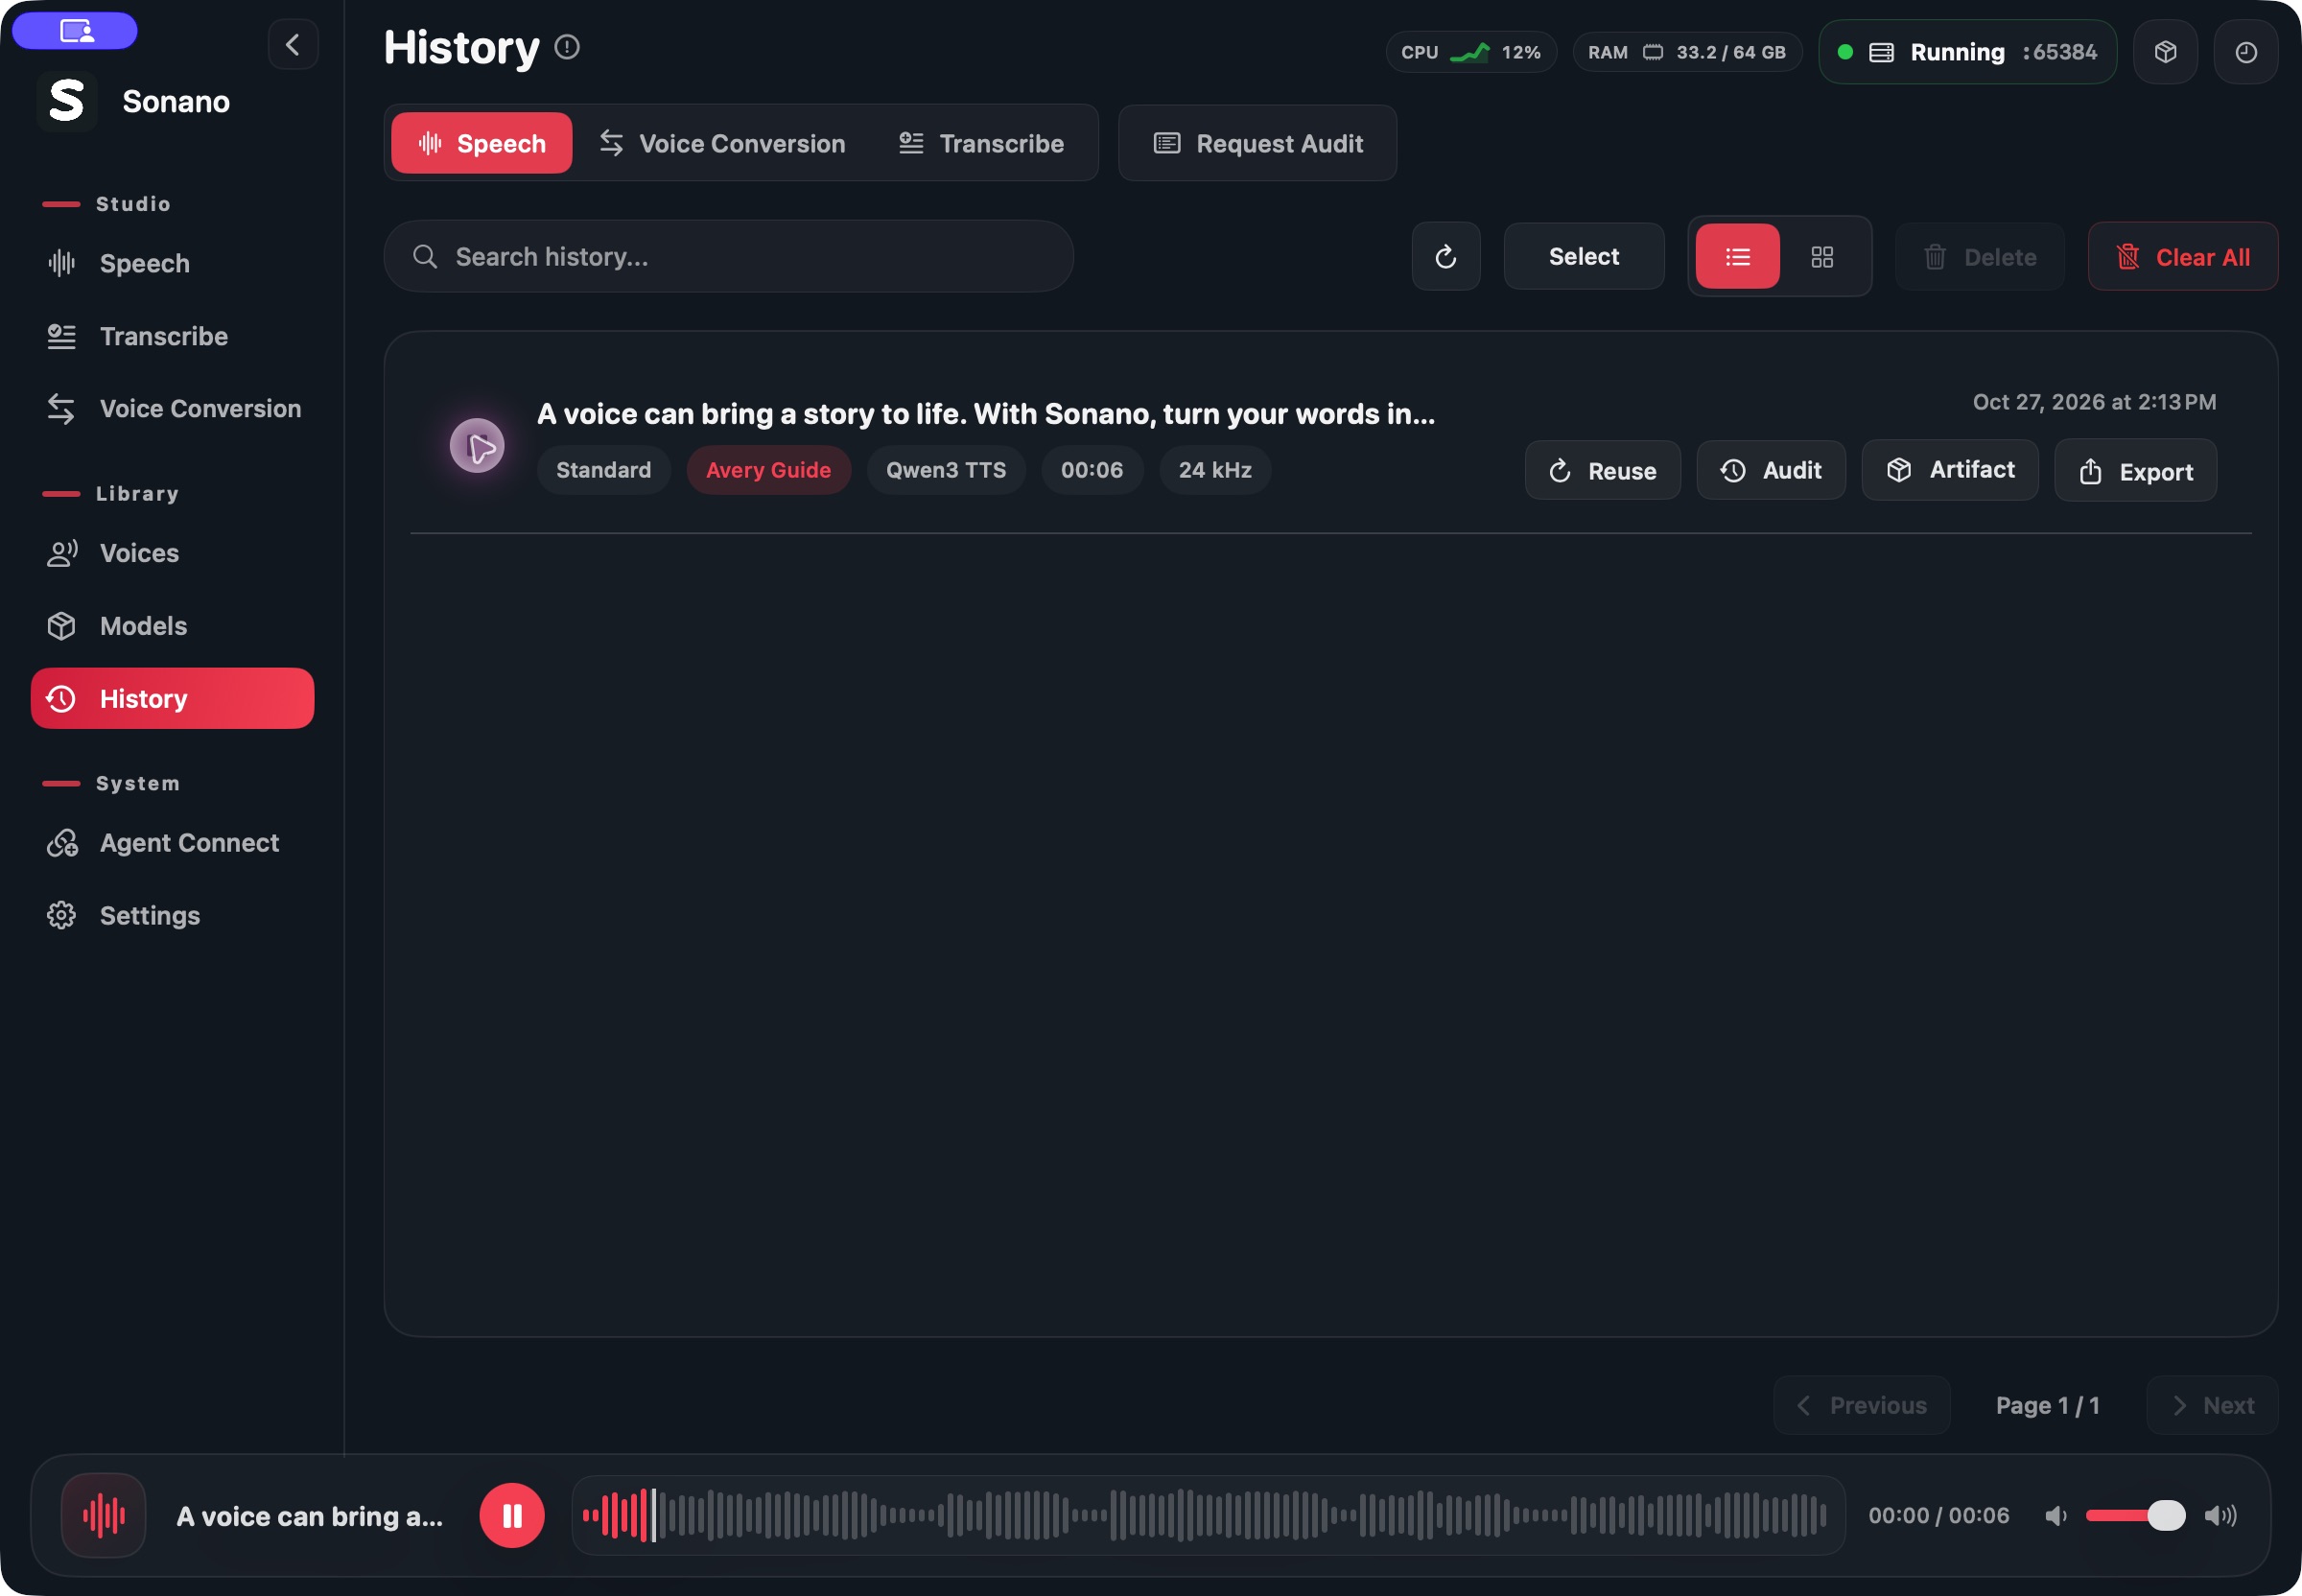
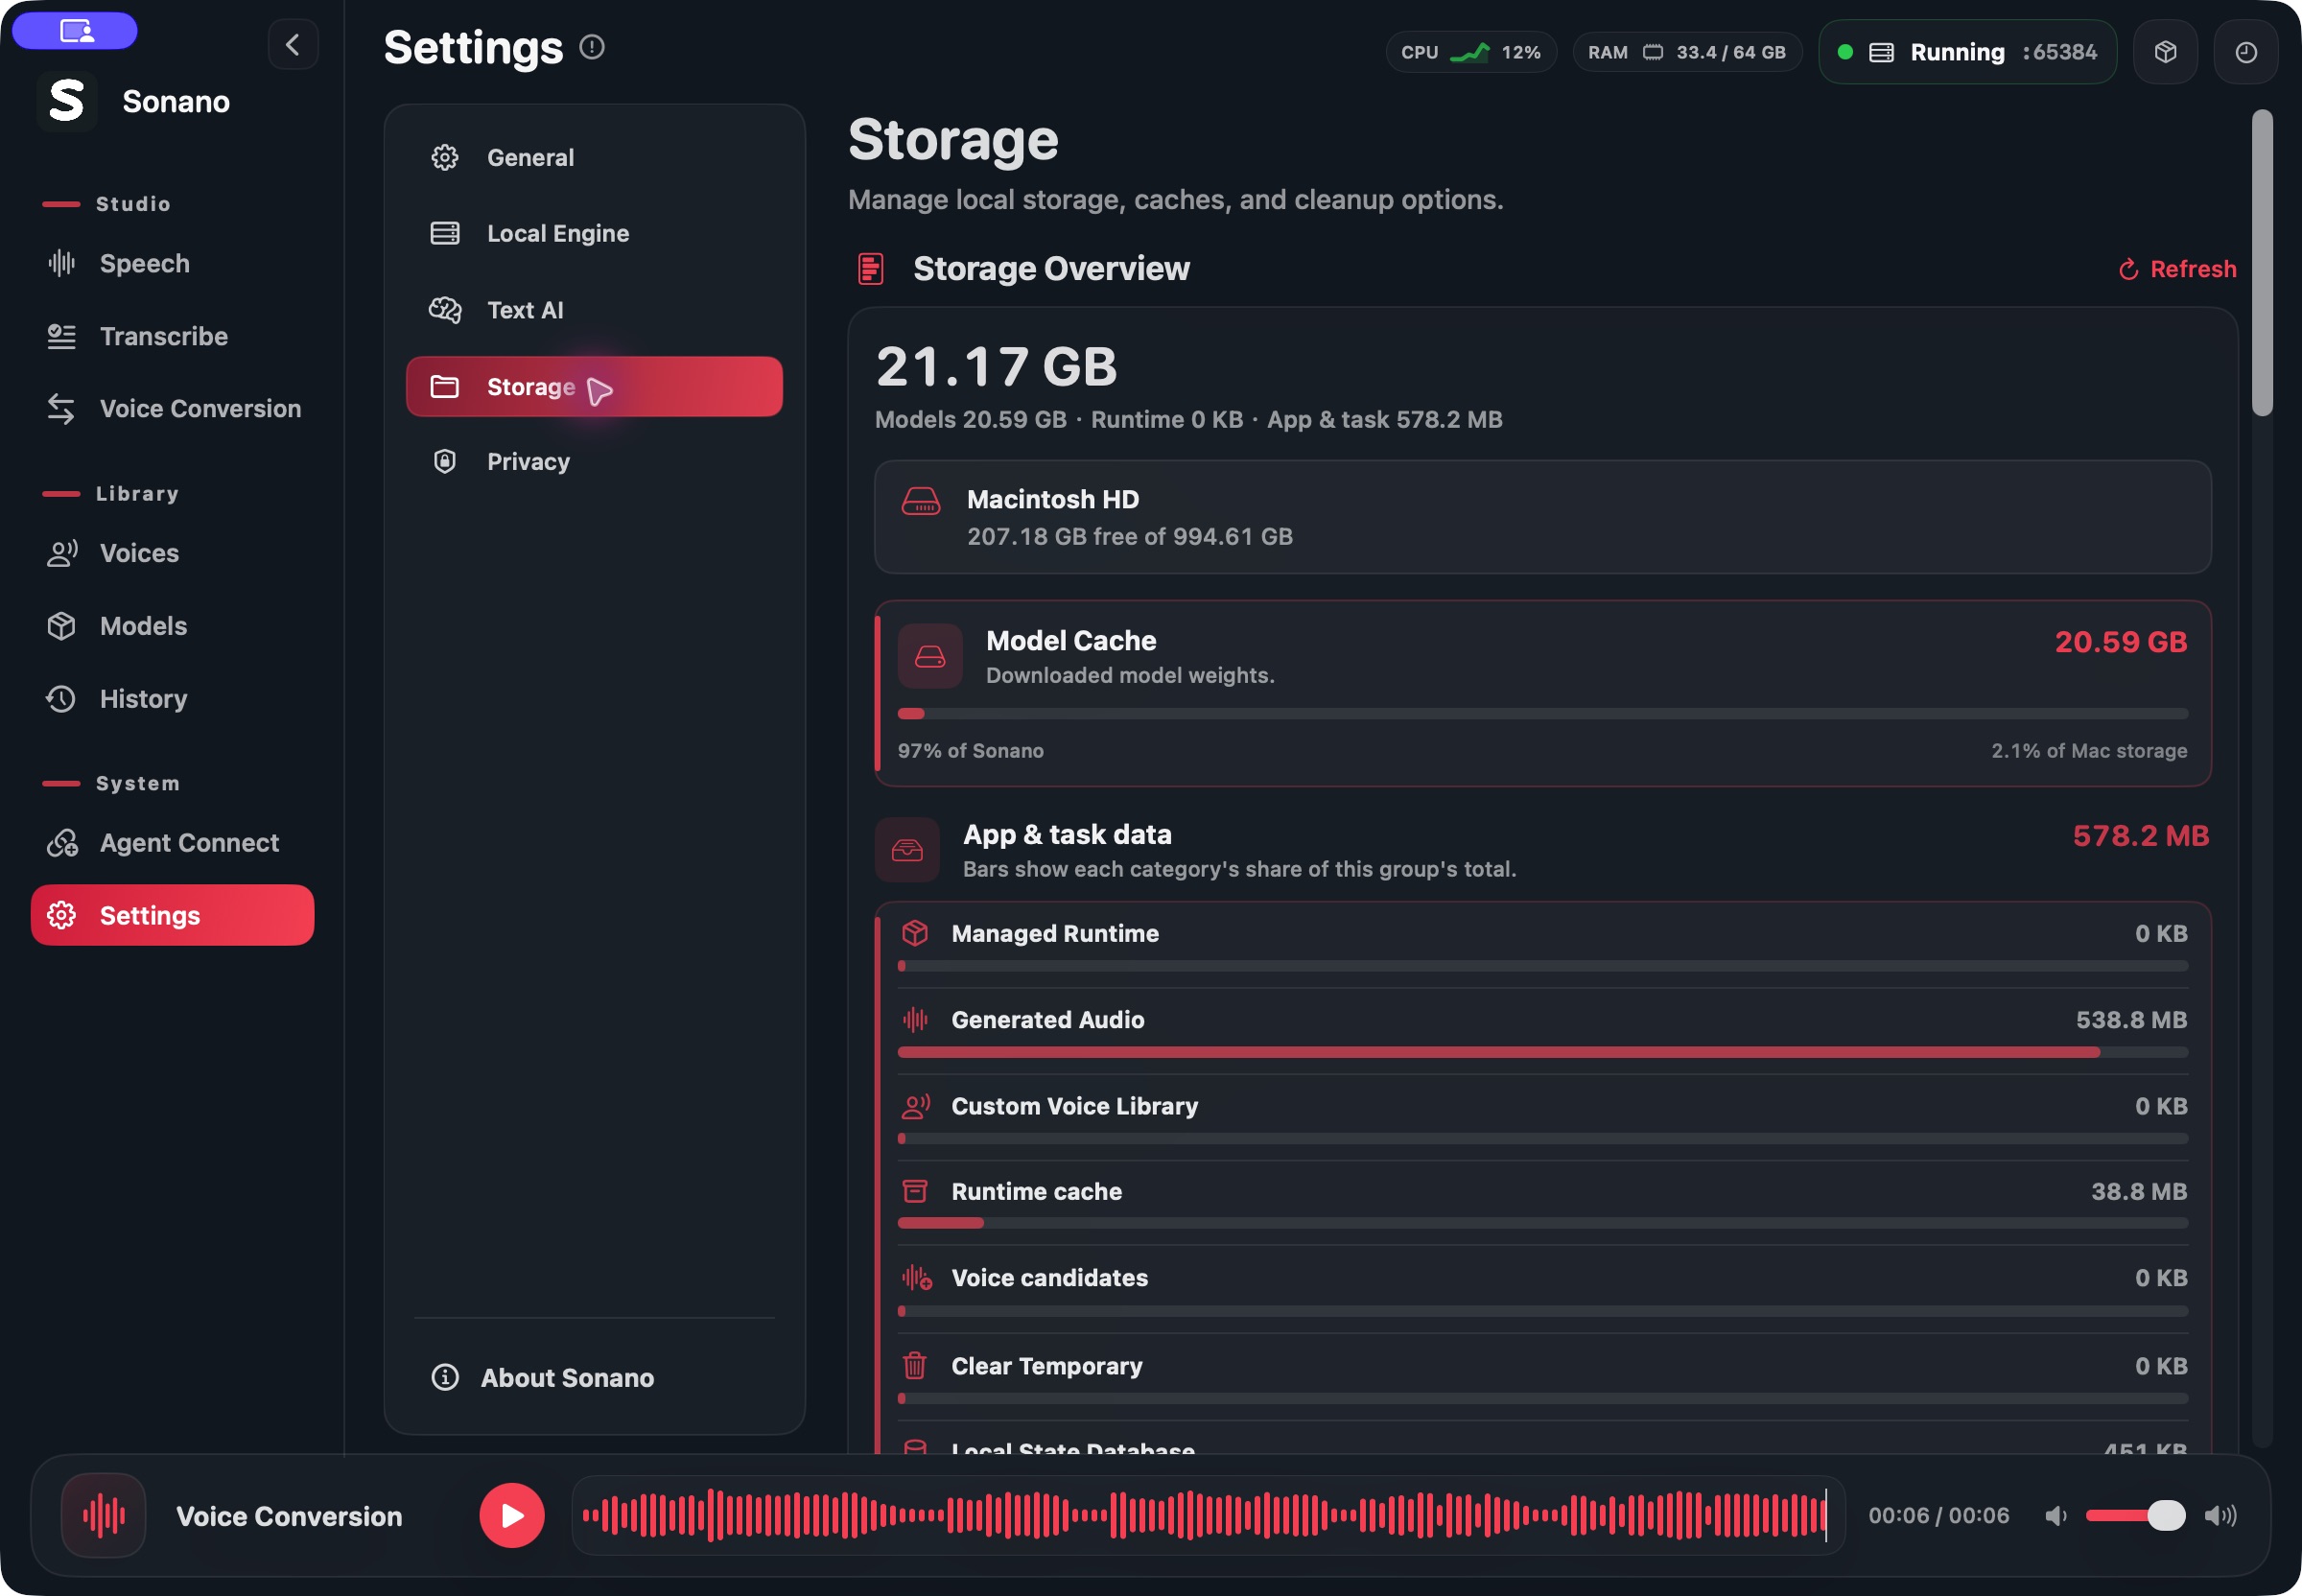
模型下载、运行时安装、生成任务、历史结果、审计记录、存储占用和隐私开关都有明确入口。Sonano 让用户看得见本地推理的真实成本和结果边界。

按任务能力组织模型,展示语言范围、推荐内存、运行时依赖、下载状态和当前可用版本。

模型下载、运行时安装、生成、转写和转换统一进入任务视图,失败和取消都有清晰状态。

生成结果不是临时音频。用户可以回到历史继续播放、复用、导出、打开分段或进入审计。

模型缓存、受管运行时、生成音频、自定义声音、状态数据库和日志分开统计与清理。
Agent 能力层
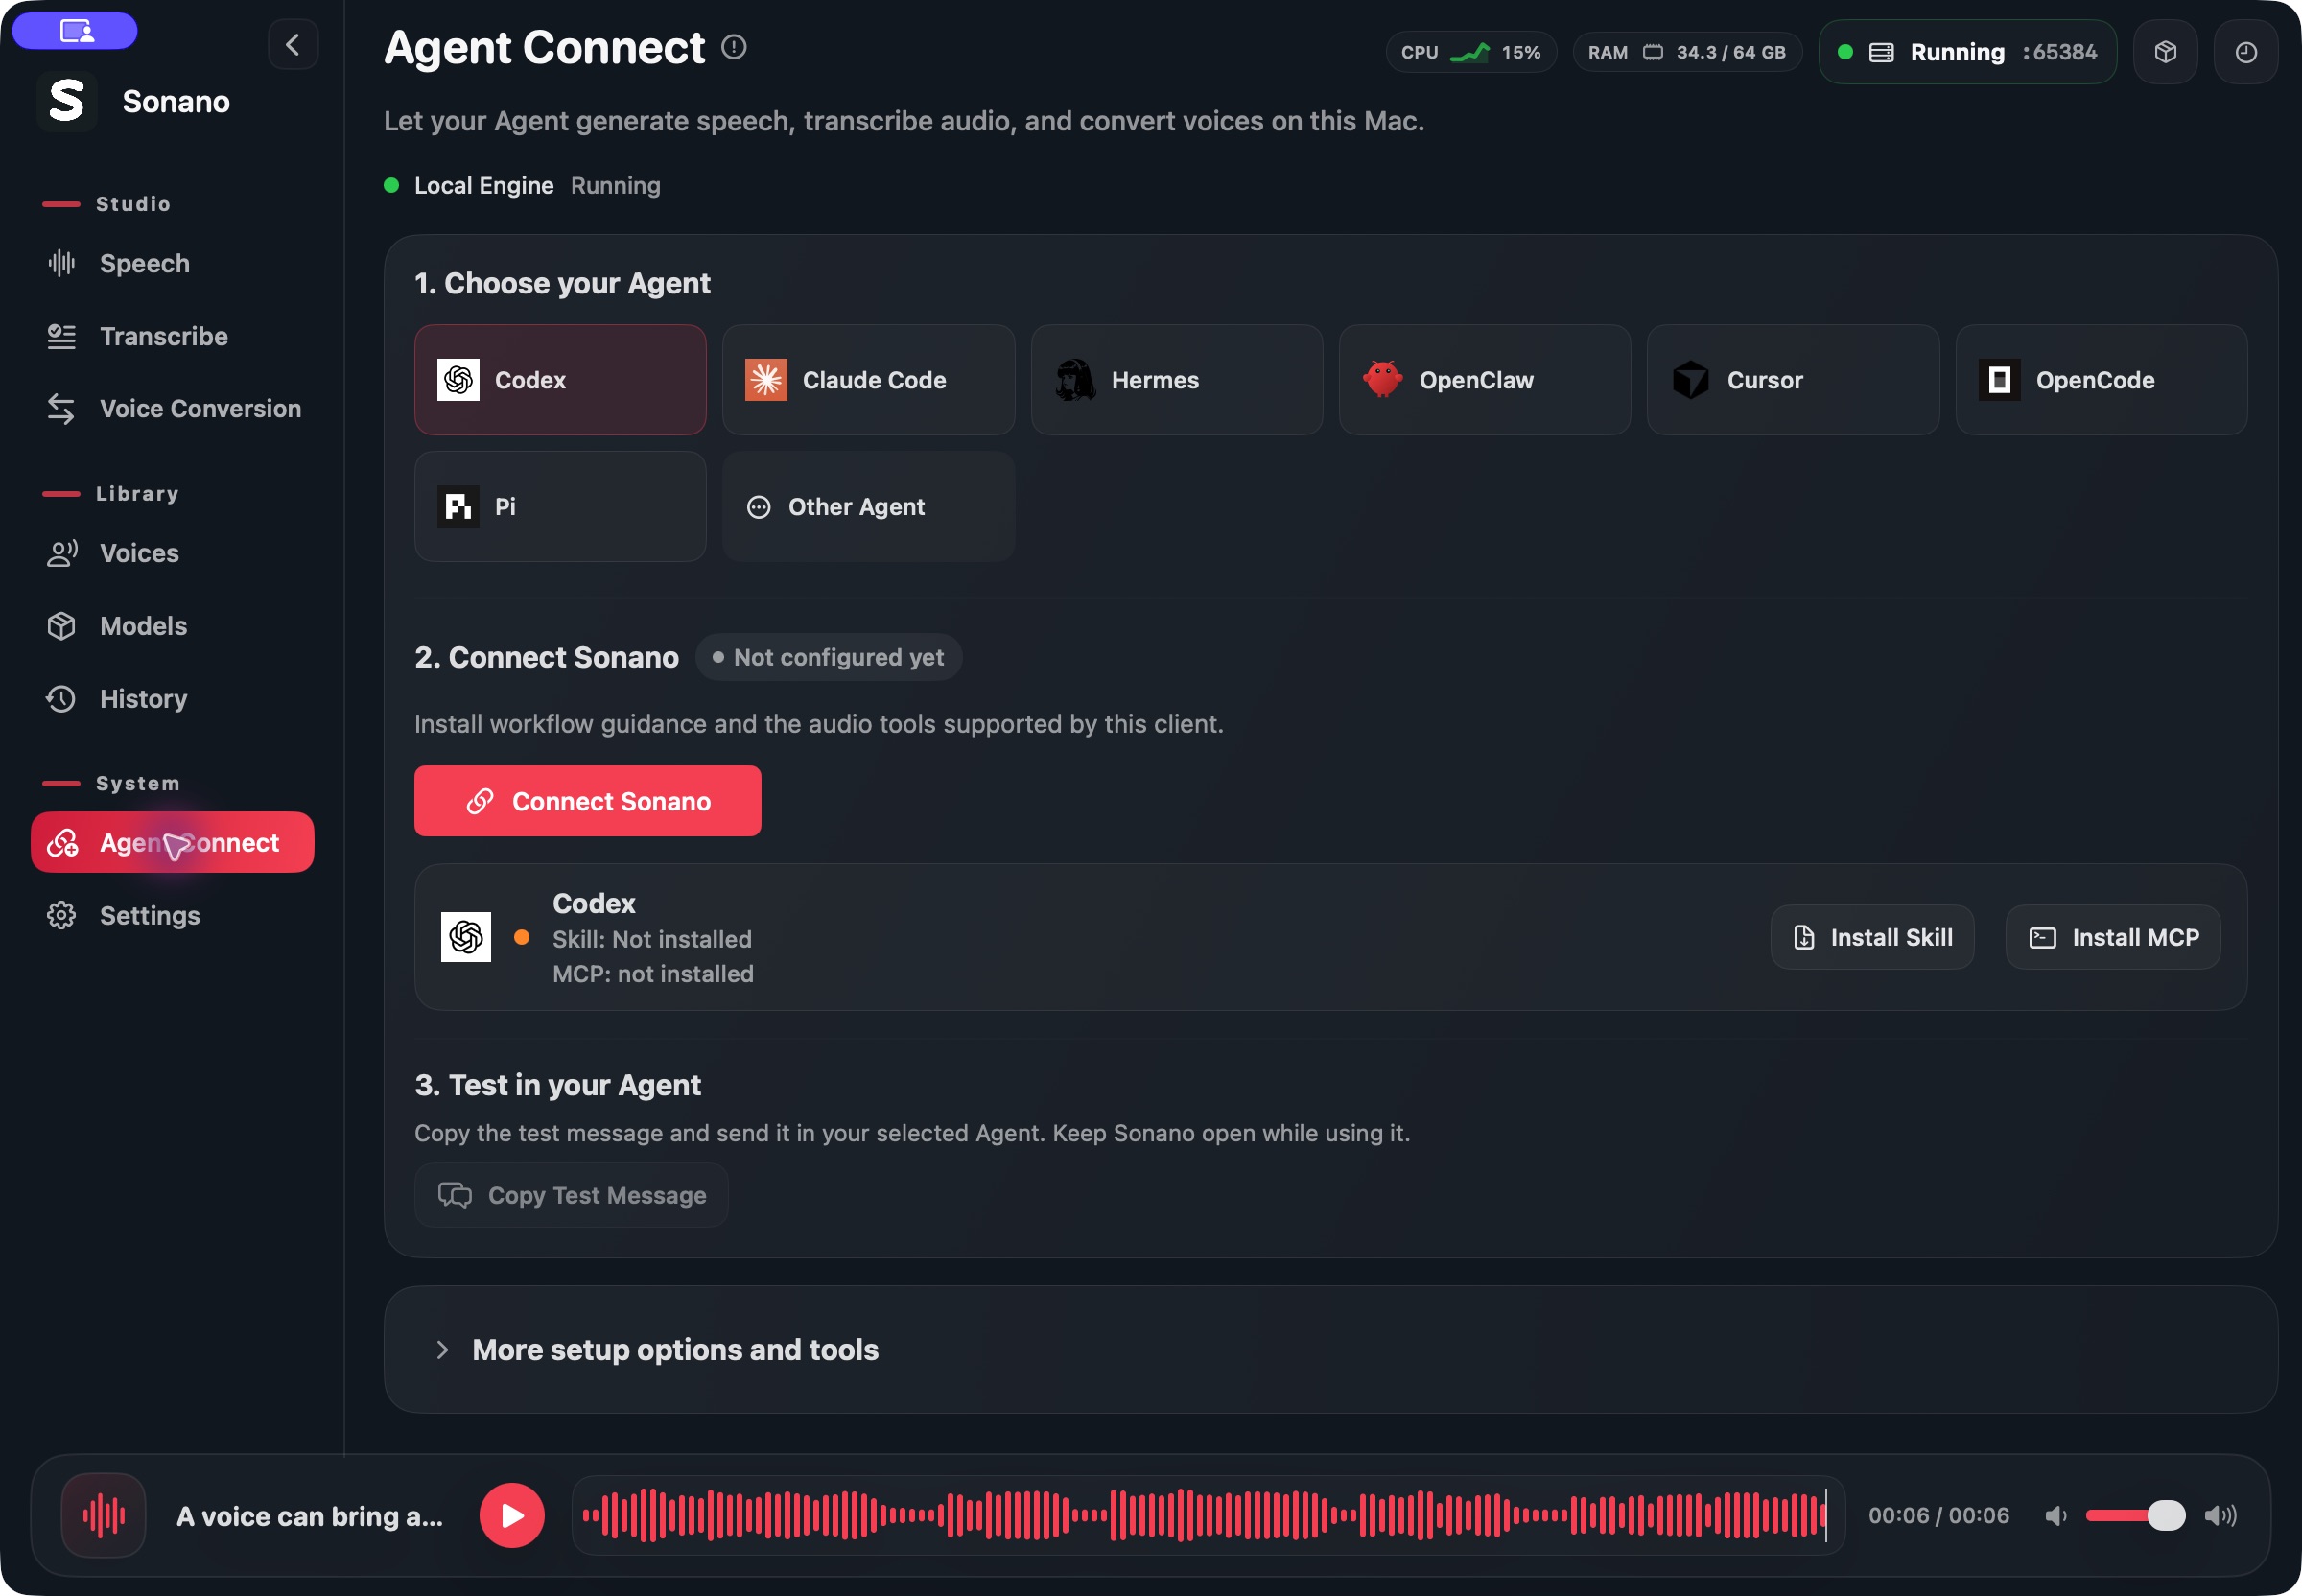
Agent 接入不是绕过 App 的隐藏 API。Codex、Cursor、Claude Code、OpenCode、OpenClaw、Hermes Agent 和脚本可以通过本地 manifest 发现能力、提交任务、追踪产物;用户仍然能在桌面端看到任务、历史和请求审计。
/agent/manifest 返回当前 ready 模型、声音和推荐默认值。127.0.0.1:19280,优先服务本机自动化。
下一步
如果你是第一次了解 Sonano,可先查看产品工作流与文档;公开安装包就绪后,下载页会提供入口。